Monter une vidéo avec l'IA en local : le pipeline Claude Code + HyperFrames
Monter une vidéo avec l'IA en local : Claude Code, HyperFrames, FFmpeg et Whisper. Le prompt d'installation, le skill de montage, les contrôles qui évitent un montage faux et les temps réels mesurés.
Par Ahmed 23 min de lecture
Tous les outils de montage IA du marché ont la même limite : tu montes chez eux, avec leurs réglages, sur leurs serveurs, et tu payes au mois. Il existe une autre voie, très différente : assembler ta propre chaîne de montage sur ta machine, pilotée en langage naturel par un agent de code.
Le principe : tu déposes un rush, tu écris « monte-moi ça », et l'agent transcrit, repère les blancs, les coupe, nettoie le son, ajoute les illustrations et exporte. Tout tourne en local, sans abonnement, et le résultat est un projet que tu peux rouvrir et corriger image par image.
Une précision d'emblée, parce qu'elle évite le principal malentendu : Claude Code n'est pas un logiciel de montage, c'est un outil de développeur. Il n'ouvre aucune timeline. Il écrit le code qui coupe. C'est une nuance de méthode, pas de vocabulaire : tu ne cliques plus, tu décris.
La vidéo en tête de cet article montre le pipeline complet en quatorze minutes, écran partagé — et elle a elle-même été montée avec lui. Ci-dessous, les commandes exactes. Compte une heure pour l'installation la première fois.

Ce que tu vas installer
Quatre briques, toutes gratuites :
- Claude Code — l'agent qui exécute. C'est lui qui lit ton rush, écrit la timeline et lance les rendus.
- HyperFrames — le framework de composition vidéo. Une vidéo y est décrite en HTML avec des attributs de temps, ce qui la rend lisible et modifiable par un agent — contrairement à un projet Premiere binaire.
- FFmpeg — le couteau suisse audio/vidéo. Sert au décodage, à la détection des silences et à l'encodage final.
- Whisper — la transcription locale (le moteur
whisper.cpp). Rien ne part sur Internet, et il gère 99 langues dont le français.
Prérequis : Node.js 22 ou plus récent, FFmpeg et Git. Sur macOS, brew install node ffmpeg git règle les trois d'un coup.
Git est le seul vrai obstacle si tu n'es pas développeur : ce n'est pas un outil de montage, c'est ce qui permet à l'agent de suivre et d'annuler ses modifications. Installe-le une fois et oublie-le — mais ne le saute pas, sinon rien ne fonctionnera ensuite.
Avant tout : réussir la prise
Cet article commençait au moment où le rush existe. C'est une erreur, parce que la moitié des échecs se joue avant : un rush raté ne se monte pas, et aucune IA ne reconstruit une piste audio trouée.
Sur macOS, ne fais jamais passer ton micro par FFmpeg. C'est mesuré et sans appel : ffmpeg -f avfoundation -i ":1" seul, sans aucune capture vidéo, perd déjà 15,4 % des échantillons — 765 micro-trous de 11 ms sur une minute. Augmenter -thread_queue_size n'y change rien. En charge réelle, un tournage de 19 minutes a été perdu en entier : 81 % d'échantillons manquants, par fragments de 21 ms. Un phonème dure 50 à 100 ms : il ne restait pas de parole à reconstruire. Passe par un enregistreur CoreAudio natif (une centaine de lignes de Swift avec AVAudioEngine suffit) — zéro perte, même pendant deux captures vidéo simultanées.
Ne tape jamais deux fois Ctrl+C sur une capture FFmpeg. Elle n'obéit pas au premier signal (encore vivante 74 secondes après, mesuré), et le second la fait quitter en « immediate exit » : l'en-tête du fichier n'est jamais écrit, le rush est illisible. L'arrêt fiable est d'envoyer q sur son entrée standard.
Vérifie la prise avant d'aller monter. Trois lignes suffisent : durée audio contre temps réel écoulé, fps réels contre fps visés, nombre de frames dupliquées. Si une ligne est rouge, on refait la prise — un audio troué est irrécupérable. Attention au piège de mesure : mpdecimate ne compte pas un débit de capture mais un changement visuel ; devant une scène immobile il annonce 12 fps là où la capture est parfaite à 30. Le bon compteur est dup= dans les statistiques FFmpeg.
Trois gestes gratuits qui sauvent un montage : filme l'application en plein écran (sinon les noms de tes autres projets, tes prompts et ta doc interne se lisent autour de la fenêtre), utilise une fenêtre de navigation privée pour les démos web (adieu notifications, favoris et bandeaux de cookies), et claque un clap au début — c'est la seule référence de synchro exacte dès que tu enregistres plusieurs pistes.
Le prompt d'installation
Ouvre Claude Code dans un dossier de travail et colle ceci tel quel :
Prépare cette machine pour du montage vidéo assisté par IA, en vérifiant chaque
étape avant de passer à la suivante :

1. Contrôle Node.js (version 22 ou plus : `node -v`), FFmpeg (`ffmpeg -version`),
   ffprobe, Git (`git --version`) et Python 3.10 ou plus. Installe ce qui manque
   (macOS : `brew install node ffmpeg git`).
2. Installe le pack de skills HyperFrames : `npx hyperframes skills`
3. Compile le moteur de transcription local sur un court extrait :
   `npx hyperframes transcribe extrait.m4a --model medium`
   (whisper.cpp se construit au premier usage, le modèle se télécharge)
4. Vérifie l'environnement : `npx hyperframes doctor --json`, confirme que `.ok`
   vaut true, et que le navigateur de rendu est présent (`npx hyperframes browser`).
5. Fais un RENDU DE BOUT EN BOUT de 3 secondes sur une composition d'exemple, et
   ouvre le MP4. Le doctor ne rend rien : il ne prouve pas que la chaîne sort un
   fichier lisible.
6. Mesure MA machine avant de me promettre quoi que ce soit :
   `npx hyperframes benchmark --runs 2 --json` sur la composition d'exemple, puis
   le même rendu avec `--experimental-fast-capture`. Donne-moi les fps des deux.
7. `git init` et premier commit dans le dossier de travail, AVANT toute autre
   modification, puis un commit après chaque étape validée. C'est ce qui rend tes
   modifications annulables.
8. Résume-moi les versions installées, les temps de rendu mesurés, et ce qui manque.
L'étape 2 est celle que les gens oublient. npx hyperframes skills installe le pack de compétences dans ton environnement : hyperframes-core (le contrat de composition), hyperframes-cli, hyperframes-creative, hyperframes-animation, hyperframes-registry et media-use. Sans lui, l'agent improvise une syntaxe qui ne se rendra pas. Avec lui, il connaît les règles du framework et travaille du premier coup. À relancer après chaque grosse mise à jour.
L'étape 3 a besoin d'un vrai fichier audio : garde un extrait de 10 secondes sous la main.
Les étapes 5 à 7 sont celles qui manquent partout ailleurs, et ce sont les moins chères à faire. Le doctor vérifie une installation, il ne rend aucune image : seul un rendu de 3 secondes ouvert à l'œil prouve que ta chaîne produit un fichier lisible. Le git init en amont est ce qui rend chaque modification de l'agent annulable — sans lui, une passe malheureuse se répare à la main.
Quant au banc de l'étape 6, il donne le seul réglage de vitesse qui paie vraiment. Mesuré sur 1 800 frames d'une composition réelle, sur un MacBook Air M2 :
| Variante de rendu | fps | Verdict |
|---|---|---|
| Réglages par défaut (3 workers) | 12,7 | référence |
--experimental-fast-capture |
21,7 | × 1,71 — le seul levier qui paie |
+ --workers 6 |
21,2 | aucun gain : 3 workers saturent déjà les cœurs performants |
+ --quality draft |
16,7 | 22 % plus lent que standard |
Retiens surtout la dernière ligne, parce qu'elle est contre-intuitive et vérifiée deux fois : ne passe jamais en draft pour « aller plus vite ». Mets --experimental-fast-capture dans le script de rendu de ton package.json dès l'installation, et ne touche pas au nombre de workers.
Les clés API, en option
Le pipeline fonctionne entièrement sans clé. Ces variables ne servent qu'à débloquer des sources externes :
export HEYGEN_API_KEY="..."       # catalogue musique, bruitages, images, icônes + voix
export ELEVENLABS_API_KEY="..."   # voix de synthèse, en second recours
export KIE_API_KEY="..."          # génération d'images (branchement manuel, voir plus bas)
Trois précisions qui t'éviteront de perdre du temps :
La voix. C'est l'option qui change le plus le résultat, et pas pour la raison qu'on croit. Son usage le plus utile n'est pas de fabriquer une narration artificielle : c'est de récupérer ta propre voix quand ta caméra et ton micro sont moyens. Tu donnes ton enregistrement brut, tu récupères la même intonation, la même diction, en qualité studio. Et si tu veux jouer, tu peux changer de timbre — plus grave, une autre voix — mais l'intérêt principal reste le sauvetage d'un son moyen.
Le moteur audio essaie HeyGen en premier, puis ElevenLabs si sa clé est présente. La différence n'est pas la qualité, c'est que HeyGen renvoie les horodatages par mot et ElevenLabs non. Si tu veux des sous-titres calés au mot sur une voix ElevenLabs, il faut repasser par npx hyperframes transcribe. Pour de la narration en français, ElevenLabs reste la référence.
Diagnostique le bruit avant de payer pour l'enlever. Sors un spectrogramme et regarde l'image :
ffmpeg -i mix.mp4 -vn -lavfi showspectrumpic=s=1500x600:legend=1:scale=log spec.png
Un ronflement se voit comme des lignes horizontales fixes (50 ou 60 Hz), un souffle comme une bande dans les hautes fréquences. Ces deux-là se retirent gratuitement, en local, avec RNNoise. Seule une nappe large bande et fluctuante — un café, du vent, la circulation — justifie de payer : aucun outil local ne sait la séparer de la voix. Teste sur 15 secondes avant de lancer le fichier entier, car le débruitage par API coûte environ 1 000 crédits la minute.
Deux pièges de niveau qui suivent, et qui ne préviennent pas :
- Un fichier débruité se recale au RMS, jamais au LUFS. Le LUFS intégré était gonflé par le bruit que tu viens de retirer : normaliser dessus sur-amplifie la voix jusqu'à l'écrêtage. Un fichier nettoyé affiche forcément un LUFS plus bas — c'est normal, ce n'est pas un défaut à corriger.
- Une voix de synthèse sort environ 12 dB sous une voix enregistrée normalisée. Si tu remplaces une section par du TTS, le mix entier est à refaire : ce n'est pas un copier-coller de piste.
Une clé d'API est un mot de passe pour les machines. Tu en donnes une à ton agent et il utilise ton compte sans te redemander à chaque fois. Trois réflexes : ne la partage avec personne, garde-la sur ta machine, et donne-lui une date d'expiration à la création. Si tu filmes ton écran pendant que tu travailles, floute-la au montage — l'agent sait le faire, mais deux pièges silencieux méritent d'être connus.
Une sortie de filtre FFmpeg ne se consomme qu'une fois. Une chaîne qui réutilise le même flux pour un recadrage et pour une incrustation ne produit aucune erreur et ne floute réellement que la dernière zone. Il faut un split explicite. Et le seul contrôle valable est de recadrer la zone floutée et de la regarder en grand : jamais le code de retour, parce que ffmpeg a rendu un fichier valide, de la bonne durée, avec une clé d'API parfaitement lisible dedans.
Un scan OCR de secrets doit utiliser des motifs lâches. Tesseract perd les premiers caractères d'une chaîne collée au bord d'un champ : une clé de 32 caractères en ressort à 28, un motif du genre \b[0-9a-f]{32,}\b ne matche plus, le scan annonce « aucun secret détecté » et la clé part sur YouTube. Descends à 20 caractères, retire les ancres de mot, et apprends à reconnaître un faux positif : une clé déjà masquée par le site (51ca3d15••••) ressort en 51ca3d15ecccccccc, les puces étant lues comme des c.
Sur la vidéo de cet article, il y a eu cinq expositions au total : trois repérées à l'œil, une par l'OCR, une par un humain qui regardait autre chose. Et comme on ne peut qu'ajouter du flou, jamais en retirer, le scan passe avant la publication, pas après.
Les images. Deux voies sont intégrées : la recherche dans le catalogue HeyGen, et la génération locale avec mflux (modèle FLUX, qui tourne sur ta machine, sans clé). C'est ce que l'agent utilisera par défaut.
Le cas Kie. Soyons clairs, parce que tu ne le liras pas ailleurs : Kie n'est pas intégré à HyperFrames. Aucune commande ne l'appellera pour toi. Si tu veux ses modèles, la voie qui marche est en deux temps : tu génères l'image via son API, puis tu l'ingères dans le projet comme n'importe quel fichier fourni, avec le mode d'ingestion de media-use (resolve --from <fichier>), qui l'enregistre et te rend un bloc prêt à coller. À demander explicitement dans ton prompt, sinon l'agent passera par les sources intégrées.
Ce qui est intégré, et ce qui ne l'est pas
Pour t'éviter de chercher une commande qui n'existe pas :
| Brique | État | Clé nécessaire |
|---|---|---|
| Transcription Whisper (whisper.cpp) | Intégrée, 100 % locale | aucune |
| Coupe des blancs | À construire (FFmpeg + transcription) | aucune |
| Nettoyage et mixage audio | Intégrés | aucune |
| Musique, bruitages, images, icônes | Intégrés (catalogue) | HeyGen |
| Génération d'images en local (FLUX/mflux) | Intégrée | aucune |
| Voix de synthèse | Intégrée | HeyGen, puis ElevenLabs |
| Kie | Non intégré — génération puis ingestion manuelle | Kie |
| Rendu (local, Docker ou cloud) | Intégré | aucune en local |
Le skill « montage »
C'est la pièce qui transforme une suite de commandes en une seule phrase. Un skill est un simple fichier markdown que l'agent lit quand la tâche correspond. Crée ~/.claude/skills/montage/SKILL.md :
---
name: montage
description: Monte un rush parlé (face caméra, tutoriel, podcast filmé) en vidéo
  finie — transcription locale, coupe des silences, nettoyage audio, illustrations
  et rendu. À utiliser dès qu'on fournit un fichier vidéo à monter.
---

# Montage d'un rush parlé

Lis `/hyperframes-core` avant d'écrire la composition, et `/hyperframes-audio`
avant de toucher au son. Ne rends jamais la vidéo avant validation humaine.

## 0. Avant tout
Commit git. Puis LIS UNE FRAME du début de chaque rush et dis-moi ce qui traîne
autour de la fenêtre utile : noms de projets, prompts, onglets, clés d'API. Ça se
règle en 10 secondes maintenant, ça coûte un recadrage plus tard.
Si le rush est une capture d'écran macOS, il est en VFR : normalise-le en CFR
avant tout le reste, sinon la dérive audio/vidéo atteint ~2 s en fin de fichier.

## 1. Transcrire
Écris d'abord `keyterms.txt` : les noms propres, outils et jargon de CETTE vidéo,
un par ligne (10 à 40 termes). Ça évite « cloud flare » ou « sonnet five » — et
le transcript est ce qui pilote toutes les décisions de coupe.
`npx hyperframes transcribe <rush> --model medium`
Garde le JSON : il porte les mots et leurs horodatages.
⚠️ Whisper NETTOIE le discours : il efface une partie des hésitations et des faux
départs qu'on veut justement couper, et sa `probability` n'est pas une confiance
acoustique. Signale-le-moi quand tu t'en sers.

## 2. Repérer les blancs
Mesure les blancs comme les INTERVALLES ENTRE LES MOTS du transcript, pas en
décibels : sur une voix faible, `silencedetect` classe la parole elle-même comme
du silence. Garde `ffmpeg -af silencedetect=noise=-35dB:d=0.6` en confirmation.
Marges : 0,20 s de respiration dans le flux de parole, 0,42 s aux frontières de
section. Un bord de coupe doit tomber dans un TROU NON VOISÉ : trace la F0
(70-350 Hz, fenêtre 32 ms, pas de 10 ms) et liste les runs non voisés ≥ 40 ms.
Une enveloppe d'énergie à fenêtre large noie un /k/ ou un /t/ de 80 ms et te fera
écrire « pas de trou propre » là où il y en a quatre.
Ne fonde JAMAIS une coupe sur des tokens répétés à `start == end` : Whisper ne les
a pas entendus, il les a inventés. Re-transcris la zone isolément avant de couper.
Signale-moi les coupes de plus de 3 secondes plutôt que de les appliquer en silence.

## 3. Monter
Un segment de parole conservé = un `<video>` avec `data-start`, `data-media-start`
et `data-duration`. Les blancs disparaissent parce qu'aucun clip ne les couvre.
Le footage doit être natif compo : 1080p à 30 fps, H.264 8-bit. Du 4K60 10-bit
HEVC affame le décodeur au compositing → frames dupliquées → saccade visible.

## 4. Nettoyer le son
Par `/hyperframes-audio` : passe-haut, gate, compresseur, limiteur. Musique = carve.
Sur un segment déjà découpé, un fade-in s'écrit `afade=t=in:st=0` : après
`atrim`+`asetpts` les timestamps repartent de zéro, et un `st=18.46` MUETTE les
18 premières secondes sans rien signaler.
Le mix final se fait en post ffmpeg, pas dans le renderer : il perd des segments
d'un long `<audio>`.

## 5. Illustrer si nécessaire
Une illustration par idée, jamais pour décorer. `/media-use` pour les images,
icônes et bruitages ; Three.js seulement quand le propos est spatial.
RÈGLE DE MONTAGE : quand le curseur bouge, clique, tape ou désigne quelque chose à
l'écran, cette zone RESTE DÉGAGÉE. Le voile plein cadre est réservé aux moments où
je parle sans rien montrer. En cas de doute, l'écran gagne : décaler une
illustration de deux secondes ne coûte rien, un clic qu'on ne voit pas casse le
tutoriel. Si la caméra est incrustée, publie son rectangle par fenêtre de temps
dans un fichier de données que toutes les scènes relisent (28 px de marge).

## 6. Vérifier — AUCUN de ces contrôles n'est optionnel
`npx hyperframes lint`, `npx hyperframes check`, puis :
a. Le check ne voit NI la synchro NI les recouvrements. Il est déjà passé à zéro
   erreur sur une composition visuellement fausse (habillage invisible, cartons
   restés sur d'anciens timecodes). Sors une planche-contact
   (`npx hyperframes snapshot --at 12,29,54,93,148,204`) et OUVRE les images.
b. Gate A/V : durée du flux v:0 == durée du flux a:0, tolérance 40 ms. Au-delà,
   c'est une erreur, pas un avertissement.
c. Re-transcris LE RENDU et compare aux mots attendus. Mots EN TROP = parole
   fantôme embarquée ; mots MANQUANTS = attaque de mot rognée. Traite chaque écart
   comme un « écoute ici », et ne déclare jamais le montage bon tant qu'il reste
   une ligne inexpliquée.
d. Mesure le RMS de parole active PAR TRANCHE (une par section, une par voix) :
   deux tranches de voix doivent tenir dans ~2 dB. C'est le seul contrôle qui
   attrape un décalage de piste que le gate A/V laisse passer.
e. Tout fichier dérivé (audio traité, transcript, proxy) porte la signature de sa
   source ; refuse de tourner si la source a bougé depuis. Sinon le décalage est
   silencieux : 13,2 s de décalage sur tout un mix, gate à 0 ms, planche-contact
   propre.
`npx hyperframes preview --background`, donne-moi l'URL, attends mon accord.

## 7. Rendre
`npx hyperframes render --experimental-fast-capture --quality high --output montage.mp4`
Seul levier de vitesse mesuré : × 1,71. Ne touche pas aux workers, et ne passe pas
en `draft` — c'est 22 % plus lent. Vérifie que le fichier existe et que sa durée
est plausible.

## 8. Resserrer, si je le demande
Ne coupe JAMAIS les blancs dans le MP4 rendu : ça tranche au milieu des animations.
Construis une fonction de remap T(t) depuis les segments conservés et applique-la à
TOUS les timecodes de la composition (b-roll, cartons, sous-titres, badges, durée
racine, durée audio), puis re-rends. Vérifie la monotonie de T, et compare le
nombre de mots avant/après avec l'ASR.
Ensuite, une phrase suffit : « monte rush.mp4 avec le skill montage ».
Ce skill est volontairement long, et chaque ligne correspond à une erreur réellement payée en production. C'est même là que se joue l'essentiel : le skill est l'endroit où l'on paye une fois pour tout ce que l'agent devra vérifier seul, à chaque vidéo. Un skill qui ne décrit que la production donne une chaîne qui rend un fichier sans erreur — et tu n'as aucun moyen de savoir si ce fichier est bon.
Comment la coupe des blancs fonctionne réellement
Il n'existe aucune commande magique qui « coupe les silences » dans HyperFrames — c'est utile à savoir avant de chercher pendant une heure. Mais le mécanisme n'est pas celui qu'on lit partout, et l'ordre des deux outils compte énormément.
Les blancs se mesurent comme les trous du transcript, pas en décibels. Un blanc, c'est un intervalle entre deux mots horodatés. C'est indépendant du niveau d'enregistrement et du bruit de fond, et c'est la seule méthode robuste. silencedetect reste utile, mais en confirmation seulement.
Pourquoi cet ordre plutôt que l'inverse ? Parce que le seuil en décibels s'effondre dès que la voix est faible. Mesuré sur une prise à −36 LUFS : silencedetect=noise=-35dB:d=0.6 a classé 36 % du rush — la parole elle-même — comme du silence. Et après normalisation du fichier, plus aucun silence n'était détecté, le bruit de fond ayant remonté avec la voix. Un seuil fixe ne peut pas être le mécanisme principal : il dépend de tout ce qu'on ne contrôle pas.
Deuxième précaution, moins évidente : Whisper nettoie le discours. Il efface une partie des hésitations et des faux départs que tu veux justement couper, et il lui arrive d'inventer des mots — typiquement des tokens répétés dont le début et la fin sont identiques. Ne fonde jamais une coupe sur ceux-là sans re-transcrire la zone : 7,5 secondes de parole fluide ont déjà été coupées de cette façon.
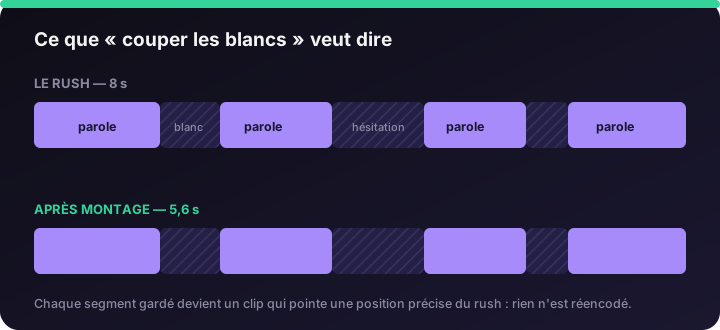
Ensuite, chaque morceau gardé devient un clip qui pointe vers un endroit précis du rush :
<video src="rush.mp4" data-start="0" data-duration="2"
       data-media-start="0" muted playsinline></video>
<video src="rush.mp4" data-start="2" data-duration="2"
       data-media-start="8" muted playsinline></video>
Lis-le comme un monteur : le premier clip joue les 2 premières secondes du rush ; le second prend la suite immédiatement sur la timeline, mais va chercher la source à 8 secondes. Les 6 secondes du milieu — l'hésitation, le blanc, la phrase ratée — n'apparaissent nulle part. Rien n'est réencodé ni détruit : ton rush reste intact, seule la fenêtre change. C'est ce qui permet de revenir sur une coupe trop serrée en modifiant un seul nombre.
Utilisé en confirmation, il te sert à valider ce que le transcript a repéré : noise=-35dB:d=0.6 fixe le seuil du silence et la durée minimale d'un blanc. À 0,6 seconde, tu gardes le rythme naturel de la parole ; en descendant à 0,3, le montage devient nerveux et parfois haletant.
Deux réglages de marge comptent autant que le seuil : garde 0,20 s de respiration à l'intérieur du flux de parole et 0,42 s aux frontières de section. Et fais tomber chaque bord de coupe dans un trou non voisé — un intervalle sans vibration des cordes vocales — plutôt qu'au premier creux d'énergie : une enveloppe à fenêtre large noie une consonne de 80 ms et te fera croire qu'il n'y a pas de point de coupe propre là où il y en a plusieurs.
L'audio, là où le gain est le plus visible
C'est contre-intuitif, mais le son fait plus pour la qualité perçue que l'image. Une vidéo un peu molle avec un son net passe pour professionnelle ; l'inverse jamais. La chaîne à demander, dans cet ordre : passe-haut pour évacuer les basses de la pièce, gate pour le bruit de fond, compresseur pour resserrer les écarts de volume, limiteur pour tenir un niveau constant. Et si tu poses une musique, le voiceover carve creuse le lit musical sous la voix au lieu de baisser tout le morceau.
Les limites, honnêtement
- Le rendu n'est pas le coût — la vérification l'est. C'est la limite la plus mal comprise, y compris dans la première version de cet article. Chiffres mesurés sur une vidéo de 14 min 38 (25 245 frames) et un MacBook Air M2 : le rendu prend 25 minutes avec les réglages par défaut, et 16 à 17 minutes avec
--experimental-fast-capture. Ce qui prend la journée, ce sont les passes de vérification et les reprises — environ 4 heures, dont les deux tiers évitables si tu outilles les contrôles comme dans le skill ci-dessus. Autrement dit : ne crois personne qui annonce « montée en 5 minutes », mais ne crois pas non plus que la machine soit le goulot. Cela dépend quand même d'elle — voir notre guide sur quel ordinateur pour le montage vidéo. - Il faut un modèle payant. Testé et retesté : le modèle gratuit ne tient pas la tâche. Monter demande de raisonner sur une transcription entière, une timeline et du code en même temps ; les petits modèles décrochent. Les deux bons plans de la section suivante existent précisément pour ça.
- L'installation n'est pas indolore. Compilation de whisper.cpp, téléchargement des modèles, versions de Node et Git à installer : prévois une heure la première fois, et laisse l'agent te guider.
- Ce n'est presque jamais bon du premier coup. Il faudra revoir la vidéo et corriger — toi-même ou en redemandant. Prévois cette passe dans ton temps de travail au lieu de la découvrir.
- L'IA ne décide pas du récit. Elle enlève les blancs, pas les passages inutiles. Elle ne sait pas qu'une phrase est de trop, ni où poser un silence volontaire. Ce tri reste ton travail.
- Ce n'est pas pour tout le monde. Si tu publies trois Shorts par semaine, CapCut te servira mieux et plus vite : notre comparatif de l'IA de montage gratuite le montre en détail.
Ce pipeline devient intéressant à partir du moment où tu montes les mêmes formats de façon répétée : un podcast filmé chaque semaine, une série de tutoriels, des rushes face caméra à dégraisser. Là où un outil en ligne te fait recommencer tous les réglages, un skill garde tes décisions et les rejoue. Le premier montage te coûte une heure d'installation ; le dixième te coûte une phrase.
Les conseils d'un monteur, pas d'un vendeur de rêve
Quatre choses qui font la différence entre un premier essai décourageant et un pipeline qui tient.
Enregistre par segments quand tu débutes. Ne tourne pas quinze minutes d'un bloc pour tout monter d'un coup. Fais ton introduction, monte-la, regarde le résultat, puis avance. Tu corriges le tir sur trente secondes au lieu de le découvrir sur un quart d'heure.
Ne demande pas tout à la fois. C'est l'erreur qui produit les résultats absurdes. Tu peux déléguer beaucoup, mais si tu demandes tout en une phrase, l'agent part dans tous les sens. Nomme les tâches une par une : ce type d'illustration ici, ce style d'animation là. Le style, c'est toi qui le décides — pas lui.
Travaille par itérations. Première passe, tu regardes. Ça ne te plaît pas ? Deuxième passe. Les premières vidéos sont lentes parce que c'est là que tu fabriques ton style : ton rythme de coupe, tes respirations gardées, ta façon d'illustrer.
Fais-lui écrire ta mémoire. Le vrai gain arrive à la troisième vidéo, à une condition : demande-lui de consigner tes préférences dans un fichier WIKI.md à la racine du projet — ton design, ton rythme, tes tics de langage à couper, tes choix d'illustration. À la vidéo suivante, il le relit et sait déjà comment tu montes. Sans ce fichier, tu réexpliques tout à chaque fois ; avec, chaque décision est capitalisée. C'est la différence entre un outil et un collaborateur.
Reste à savoir quoi y écrire. Six sections suffisent :
# WIKI — <ma chaîne>
## Identité       couleurs, typo, ce qu'on ne fait jamais
## Cadrage        formats, zones interdites, où va la caméra
## Rythme         marges de coupe, ce qu'on coupe toujours / jamais
## Audio          cible de loudness, chaîne de traitement, voix utilisées
## Leçons         un titre = une erreur payée = son correctif
## Commandes      les commandes exactes qui font foi pour ce projet
La section Leçons est celle qui paye. Chaque entrée coûte une erreur réelle, et l'agent la relit à la vidéo suivante : c'est ce qui sépare un simple fichier de préférences d'une véritable mémoire de production.
Deux bons plans si le budget bloque
Puisqu'un modèle payant est nécessaire, autant connaître les deux voies pour ne pas le payer plein tarif.
Si tu es dans une association : Claude for Nonprofits. Anthropic applique jusqu'à 75 % de remise aux organisations vérifiées, avec un plan Team autour de 8 $ par utilisateur et par mois au lieu de 20 à 25 $, et des crédits offerts à l'ouverture. Tu remplis un formulaire, ton dossier est étudié en quelques jours. Si tu es membre d'une asso, c'est le meilleur rapport qualité-prix du marché — profites-en tant que le programme tient.
Si tu n'as pas de budget du tout : Verdent. C'est un outil d'agent de code en application de bureau, dans le même esprit, qui donne accès gratuitement à deux modèles sérieux : GLM 5.3 Flash et DeepSeek V4 Flash (avec des plafonds d'usage par tranches de 5 heures et à la semaine). GLM 5.3 Flash n'a rien d'un modèle au rabais — il est entraîné à inspecter des interfaces rendues et de la sortie 3D, ce qui tombe bien pour du montage. Des vidéos entières ont été montées avec. C'est une offre à durée limitée : à tester maintenant plutôt que dans six mois.
Pour le reste, notre guide complet du montage vidéo IA fait le tour de ce que l'intelligence artificielle sait faire, et notre comparatif des logiciels de montage IA chiffre les solutions clés en main.
Questions fréquentes
- Peut-on monter une vidéo avec l'IA sur sa propre machine ?
- Oui, et toute la chaîne technique est gratuite : HyperFrames, FFmpeg et Whisper (whisper.cpp) tournent en local, et ta transcription ne quitte jamais ton ordinateur. Il te faut Node.js 22 ou plus, FFmpeg et Git. Seul le modèle d'IA qui pilote le montage doit être payant — les clés HeyGen ou ElevenLabs, elles, restent optionnelles et ne servent qu'aux voix, musiques et images.
- Comment couper automatiquement les silences d'une vidéo ?
- En mesurant les intervalles entre les mots du transcript Whisper, pas en décibels : sur une voix faible, un seuil comme `silencedetect=noise=-35dB` classe jusqu'à 36 % de la parole elle-même comme du silence. Le transcript donne les blancs, `silencedetect` sert à les confirmer. On garde ensuite 0,20 s de respiration dans la parole et 0,42 s aux frontières de section, en faisant tomber chaque coupe dans un intervalle non voisé.
- Faut-il une clé API ElevenLabs ou Kie pour ce pipeline ?
- Non, le pipeline fonctionne sans aucune clé. ElevenLabs (variable ELEVENLABS_API_KEY) sert de second recours pour la voix de synthèse, après HeyGen. Kie, en revanche, n'est pas intégré au framework : pour utiliser ses modèles d'images, il faut générer l'image via son API puis l'ingérer manuellement dans le projet.
- Ce pipeline remplace-t-il un logiciel de montage classique ?
- Pas pour du montage créatif ponctuel : l'IA retire les blancs, pas les passages inutiles, et ne choisit pas le récit. Il devient rentable quand tu montes des formats répétitifs — podcast filmé hebdomadaire, série de tutoriels, rushes face caméra — parce que le skill garde tes décisions et les rejoue.
- Combien de temps prend un montage vidéo réalisé par l'IA ?
- Le rendu lui-même est rapide : environ 25 minutes pour une vidéo de 15 minutes, et 16 à 17 minutes avec l'option de capture rapide (mesuré sur un MacBook Air M2). Ce qui prend du temps, ce sont les passes de vérification et les reprises — environ 4 heures, dont les deux tiers évitables si les contrôles sont outillés dans le skill. Personne ne monte une vidéo en 5 minutes, mais le goulot n'est pas la machine.
- Ce montage vidéo par IA est-il possible gratuitement ?
- Les outils du pipeline (HyperFrames, FFmpeg, Whisper) sont gratuits, mais le modèle d'IA qui pilote doit être payant : les modèles gratuits ne tiennent pas une tâche qui demande de raisonner sur une transcription, une timeline et du code à la fois. Deux contournements : Claude for Nonprofits, à environ 8 $ par utilisateur et par mois pour les associations vérifiées, et Verdent, qui donne accès gratuitement à GLM 5.3 Flash et DeepSeek V4 Flash avec des plafonds d'usage.
#claude-code #ffmpeg #hyperframes #ia vidéo #montage vidéo IA #whisper