Court-métrage d'animation avec l'IA : le guide complet, prompts réels inclus
Réaliser un court-métrage d'animation avec l'IA, c'est d'abord une vision. Les vrais prompts, la stack, les contrôles qualité et comment refaire une scène.
Par Ahmed 32 min de lecture
Read in English: How to Make an Animated Short Film with AI: The Full Workflow (Real Prompts)
Un court métrage IA, on pense tout de suite au bouton magique : on tape une phrase, un film sort. Ce n'est pas ce qui s'est passé ici. J'ai réalisé un film de 1 min 45, dessiné entièrement avec des lettres et des chiffres, en dirigeant des modèles d'IA comme on dirige une équipe : je décris, je regarde, je dis ce qui ne va pas, ils refont.
Ce guide te montre tout, dans l'ordre : la vision, la stack technologique, le pipeline étape par étape avec les vrais prompts, les contrôles qui m'ont évité de livrer n'importe quoi, et la manière de changer d'avis sans tout perdre. Il y a aussi ce qui a raté, parce que c'est là qu'on apprend.
L'essentiel en quatre lignes
- La vision passe avant tout : ce que tu veux dire, avec ta voix.
- La direction artistique (DA) compte plus que le détail de l'animation : elle s'écrit dans un contrat que l'IA relit.
- Tu es le réalisateur, l'IA est ton outil : elle exécute et mesure, tu regardes, tu écoutes, tu tranches.
- Aucun « en un seul prompt » : des dizaines d'échanges, des versions gardées, des contrôles à chaque étape.
Le film terminé est à voir ici : https://youtu.be/pyDx5ITCebE?t=274 (le film complet commence à 4:34 dans le tutoriel).
Le tutoriel vidéo Dans le tutoriel vidéo (YouTube, chaîne Easyvidéo) je renvoie vers cet article : tous les prompts et toutes les étapes y sont. Le tutoriel en français : https://youtu.be/pyDx5ITCebE. La version anglaise (chaîne Ahmed T'aide) : https://youtu.be/XigOMjfS7GE.
D'abord ta vision, ensuite les outils
C'est le message que je veux faire passer avant toute technique : ce qui compte, c'est ta vision. Ta voix, ce que tu veux transmettre au monde. L'IA t'aide à réaliser la vidéo ; elle ne décide pas à ta place de ce qu'elle doit dire.
Quelques principes que j'ai tenus du début à la fin :
- La direction artistique est importante. Un style cohérent vaut mieux qu'une animation ultra détaillée.
- Pas besoin d'animations ultra détaillées pour servir un message, un discours, une vision. Des gestes simples (un souffle de vent, une chute, une apparition) suffisent s'ils sont justes.
- Tu es le réalisateur ; l'IA est ton outil. Elle exécute vite et refait sans se plaindre ; ce que le film doit faire ressentir, c'est ton rôle.
- La simplicité des mots. Un retour efficace tient en une phrase concrète. On y revient plus bas.
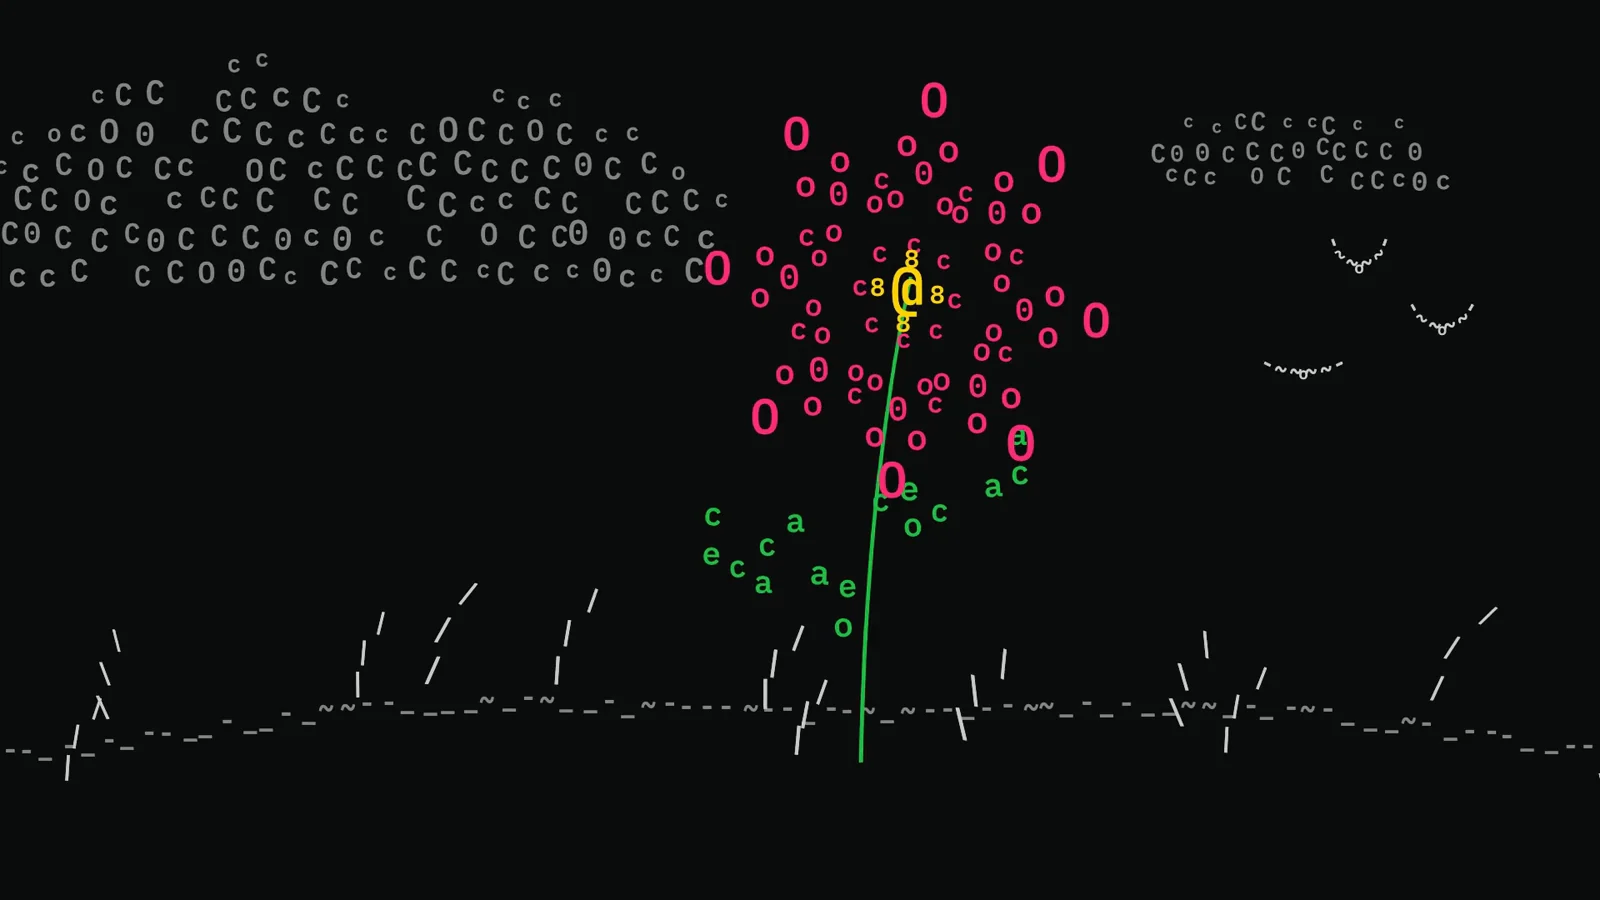
- Les lettres peuvent aussi illustrer : un nuage fait de « C », une fleur en
0 o @, une tige en|.
Le film : un message simple
Le film pose trois questions, avec sobriété : Quand a-t-on arrêté de compatir ? Quand a-t-on arrêté d'être des êtres humains ? Et quand, et pourquoi, on parle à la place de Dieu pour justifier des horreurs ?
Il parle de la guerre, de la souffrance des enfants, des femmes, de toutes les personnes qui n'ont rien demandé. Il ne montre aucune violence : on suggère par le silence, le contraste et l'absence. Voici le texte de la voix off, dans la version anglaise du film :
When did we stop being human? When did other people's suffering stop moving us? When did we start hiding behind God to commit atrocities? So many people in this world are suffering, people who never asked for any of it, and we, the ones who watch and who hear, pretend that everything is fine. A woman weeping, a child screaming in pain: we no longer hear them, we no longer feel anything. And those who inflict that pain justify it by saying it's God's will. In God's name? Really? The one thing that is beautiful about death is that even the executioners will die in the end, and join the innocent they harmed... So tell me, when did we stop being human?
Règles de contenu retenues pour le film : aucun corps, aucun visage, aucune arme visible, pas de char ; les enfants sont de simples silhouettes de lettres, sans visage ; une seule flaque, à la fin ; l'explosion, très brève et faite de lettres, n'apparaît que dans le film final, et jamais en gros plan sur autre chose que des lettres.
La direction artistique : tout est écrit en lettres
J'ai choisi une DA qui force la retenue : tout est dessiné avec des lettres et des chiffres. Si on zoome, on lit des lettres. Le fond est un aplat sombre, le monde est gris, et dans chaque scène un seul élément porteur de sens est en couleur (dans la première : la fleur).
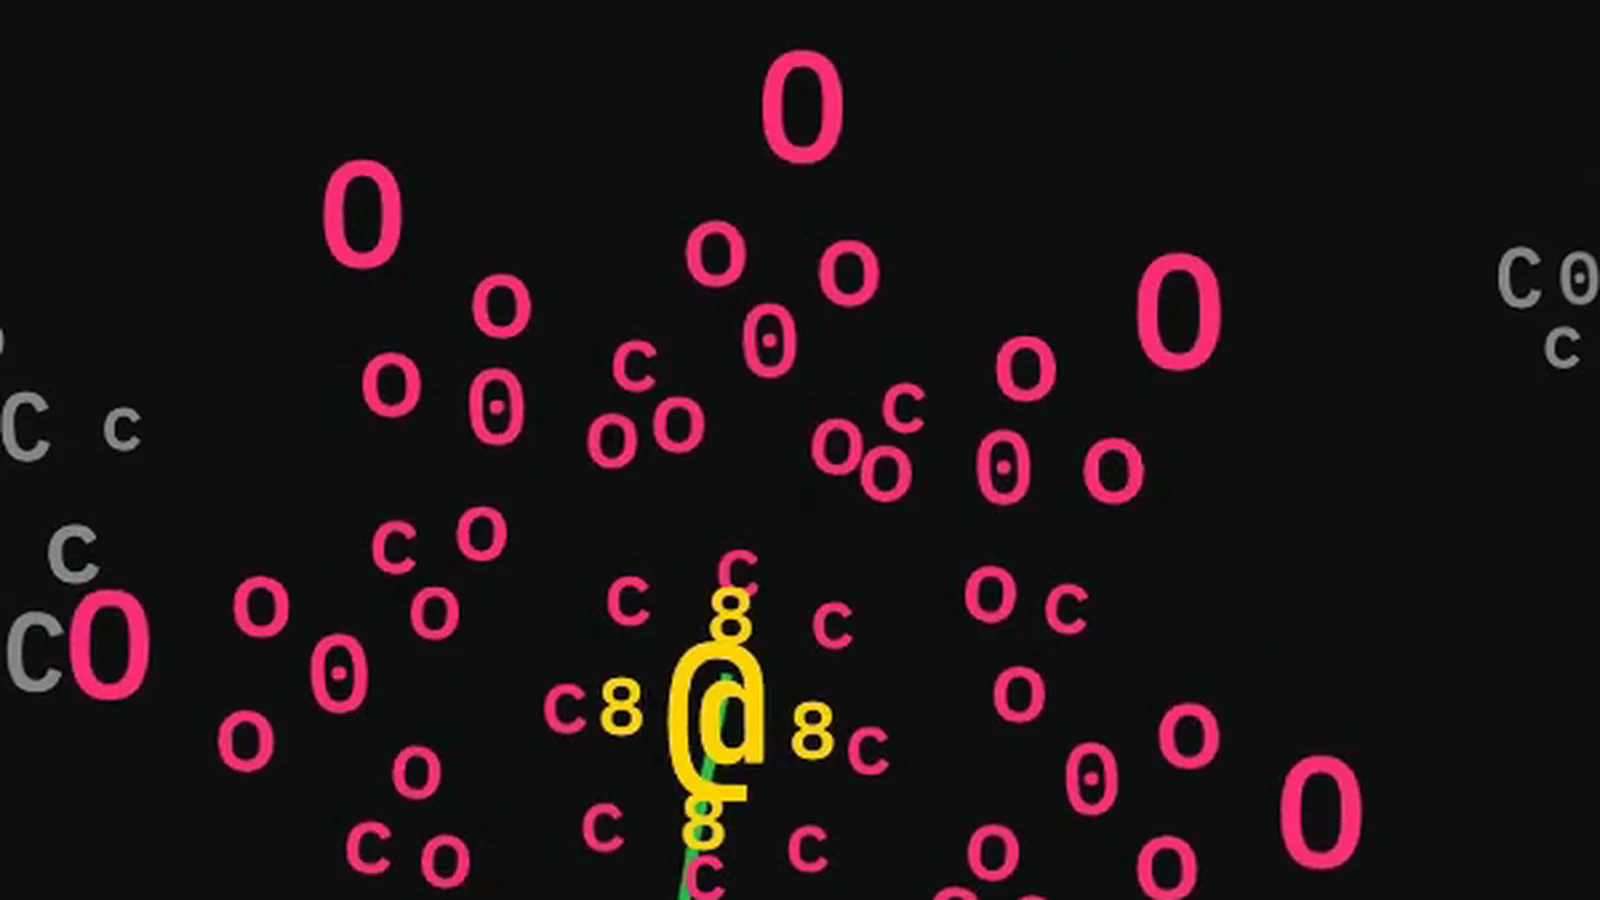 Zoom sur la scène 1 : les pétales sont des
o, 0 et O, le cœur un @, la tige une colonne de |.
Ce que ce guide promet (et ne promet pas)
Pas d'« en un seul prompt » : ce film a demandé des dizaines d'échanges et un montage entièrement refait. Pas de coût ni de durée de production annoncés : je ne les ai pas mesurés. Ce guide décrit ce qui s'est réellement passé le 22 octobre 2026, avec les outils de ce jour-là, et te donne les prompts, les contrats, les contrôles et les pièges pour refaire la démarche avec ton message.
Que tu veuilles faire un court métrage, créer une vidéo avec l'IA ou lancer ta première animation IA, la méthode est la même.
La stack technologique
Voici ce qui a réellement servi, avec pour chaque outil son rôle ici et un piège vérifié.
| Outil | Rôle dans ce film |
|---|---|
| Claude Code (terminal) | Le chef d'orchestre : conçoit, code, mesure, relit |
| Claude Sonnet 5.5 (effort « high ») | DA, traitement, scènes « types », plan-séquence final |
| Claude Haiku 5.5 | Réalise les autres scènes, en parallèle |
| HyperFrames (0.6.112) | Rend une page HTML/canvas + GSAP en MP4, image par image |
| ElevenLabs | Voix off (eleven_v4), effets sonores (sound-effect-v2), musique |
| whisper.cpp | Relit la voix pour comparer au texte écrit |
| ffmpeg | Mixage, mesures (LUFS, crête, silence), planches de contrôle |
Claude Code : Sonnet 5.5 pour concevoir, Haiku 5.5 pour réaliser
- Sonnet 5.5, effort « high » seulement. Je commence par décrire ce que je veux à Sonnet 5.5 en « high », pas plus : pas besoin de plus de raisonnement pour ça. Avec lui, je valide l'animation, le style, la DA, et je fais surtout les premières animations types.
- Haiku 5.5 pour la suite. Rapide, il réalise les scènes en parallèle, par vagues de quatre, en suivant le modèle.
- Un Sonnet « réalisateur » pour le plan-séquence final.
- Piège réel : lancer trop d'agents d'un coup. Une session précédente avait atteint sa limite avec 13 agents Opus en parallèle ; ici, vagues de 4.
HyperFrames : le rendu déterministe
- À quoi il sert : une scène est une page HTML avec un
<canvas>et GSAP ; HyperFrames la rend en MP4, image par image, de façon déterministe. Les glyphes sont dessinés en canvas, en police monospace. - Commandes utilisées :
lint,snapshot --at …,render(versionhyperframes@0.6.112, sans commandecheck). - À savoir : le rendu est lent ; on le lance en arrière-plan, sortie redirigée vers un fichier.
- Piège réel :
lintvert ne prouve rien. Une exception dans la fonction de dessin avait fait sortir une image sans fleur ni herbe, lint vert, aucun message. Il faut regarder un snapshot après chaque changement de structure.
Si tu veux comprendre cette chaîne en détail (installation, Whisper, FFmpeg), lis monter une vidéo avec l'IA en local avec Claude Code et HyperFrames.
ElevenLabs : la voix, les effets, la musique
- Voix off : modèle
eleven_v4, voix « Hale » (EN, triste), avec balises d'émotion[sad, quiet, slow],[voice trembling],[whispers],[pause]. Le service renvoie aussi des timestamps de mots. - Effets sonores :
sound-effect-v2(13 effets générés, catalogués danssfx-catalog-all.json). - Musique : des segments de chœur a cappella ont été générés avec le modèle
music_v1d'ElevenLabs ; le projet contient aussi un script de secours chez fal.ai (Stable Audio 2.5), prévu pour quand le quota de musique ElevenLabs est épuisé. - Ce qui a échoué :
eleven_v4n'a pas de mode effets sonores. J'ai fait 12 essais de « vent » : un texte fait seulement de balises est refusé (erreur 400) ; avec des « … » comme texte, il joue des souffles humains (soupirs, murmures). Le modèle SFX dédié,sound-effect-v2, a sorti un vrai vent continu. - Autre échec : le service tiers par lequel passaient d'abord les SFX (kie.ai) est tombé le 22 octobre ; j'ai contourné en appelant directement l'API du même modèle.
- Piège : les timestamps de mots dérivent de 0,1 à 0,7 s. Pour couper, on s'appuie sur les vrais silences du fichier audio, pas sur ces horodatages.
whisper.cpp : relire ce que la voix a dit
- À quoi il sert :
whisper-cli(modèleggml-small) retranscrit la voix, pour comparer le texte dit au texte écrit. - Ce qu'il a trouvé ici : le passage « we no longer feel anything » était avalé par le mode chuchoté de la voix. Corrigé avec
[softly]et une pause. - Piège : sur un long fichier, whisper peut sauter un mot. On le fait passer par morceaux de 10 secondes.
ffmpeg : mesurer tout ce qu'on peut mesurer
- À quoi il sert : mixage, niveau (LUFS, crête), silence (
volumedetect), planches de contrôle, assemblage sans perte des tranches de rendu. - Piège : l'AAC remonte la crête : on mesure le fichier final, pas le WAV. Et
-shortestpeut couper une image.
La structure du projet
Un projet, un dossier. Chaque fichier a un rôle précis : plusieurs agents peuvent travailler sans se marcher dessus.
lettres-guerre/
├── BRIEF.md            ce que j'ai demandé à Sonnet (sujet, DA, scène 1, livrables)
├── DA.md               le CONTRAT de la direction artistique (palette, polices, densité, recettes, QA, pièges)
├── SCENARIO.md         les 9 scènes : durée, voix, image, élément coloré, sons
├── TRAITEMENT.md       premier traitement en 8 scènes (obsolète, gardé pour l'historique)
├── script.json         texte de la voix + balises d'émotion v4
├── sfx-catalog-all.json  les 13 effets sonores demandés
├── audio/
│   ├── vo/             voix (hale.mp3, ash.mp3) + horodatages des mots
│   └── musique-essais/ essais de chœur
├── scenes/
│   ├── s01/ … s09/     une scène = un mini-projet (index.html, gust.js, gsap.min.js,
│   │                   fonts/, audio/, hyperframes.json, package.json, snapshots/)
├── plan-sequence/      le film final : index.html, world.js, plan.json, PLAN.md, PIEGES.md, tools/
├── renders/            tous les rendus, versions comprises (s01-v1-dense.mp4, s03-v3-char.mp4…)
└── tools/              tts_vo.py (voix), assemble.py (premier montage)
Un exemple de contrat DA.md
DA.md est le fichier le plus important : c'est lui qui permet à un modèle plus petit de refaire un objet de plus sans deviner. Voici le début, tel quel (avec […] là où je coupe) :
# DA « lettres et chiffres » — le contrat

Tout ce qui est à l'écran est une lettre, un chiffre ou un signe de ponctuation tapé en police
monospace. Aucune forme pleine, aucun trait, aucune image.
Principe (retour d'Ahmed, v2) : peu de lettres, aérées. Chaque lettre doit se voir, avec de l'air
autour […]
Règle de couleur (retour d'Ahmed, v3) : le monde est en noir et blanc, un seul élément porteur
de sens est en couleur par scène. […]
Aplats (retour d'Ahmed, v4) : aucun dégradé, nulle part. Le fond est un seul aplat (#0E0E0E) […]
Peu d'éléments (retour d'Ahmed, v4) : 1 sujet + 2-3 éléments de décor maximum par scène. […]

Règle absolue : aucune violence montrée […]
Chaque correction du réalisateur devient une règle écrite (« retour d'Ahmed, v2, v3, v4 ») que les scènes suivantes respectent.
Le pipeline, étape par étape
Pour chaque étape : ce que j'ai dit, ce que l'IA a fait, pourquoi le prompt est construit ainsi. Les phrases en français sont les miennes, nettoyées (fautes de frappe retirées), pas réécrites.
Étape 1 : décrire sa vision à Sonnet 5.5, valider la DA, faire la scène « type »
« Je commence par décrire ce que je veux à un modèle Sonnet 5.5 en high seulement, pas besoin de plus de raisonnement. Avec ce modèle je valide l'animation, le style, la DA, et je fais surtout les premières animations types. »
Mon prompt, l'essentiel :
Le film parle de la guerre, de la souffrance des enfants, des femmes, des personnes qui n'ont
rien demandé.
La DA : des dessins faits avec des lettres et des chiffres. Par exemple, un nuage fait de « C »
arrangés pour former un nuage. Pas de violence visible.
Première scène : fond bleu (le ciel), des nuages, une fleur qui bouge avec le vent, un léger
mouvement de caméra, des oiseaux qui volent au loin. On entend le vent, la fleur bouge au
rythme du vent. Scène poétique. SFX ElevenLabs.
J'ai aussi écrit un brief complet, BRIEF.md, avec une section « ce que Sonnet doit livrer » :
## Ce que Sonnet doit livrer
1. TRAITEMENT.md : explication du court-métrage en français […] 6-8 scènes […] toujours sans violence.
2. DA.md : le contrat de la DA « lettres et chiffres » : palette, polices (monospace), densité de
   glyphes, techniques (comment on fait un nuage, une fleur, un oiseau, de l'herbe, une ombre),
   mouvement (vent, respiration), règles de caméra […], son. Assez précis pour qu'un Haiku refasse
   un objet de plus sans deviner.
3. scenes/s01/ : la scène 1 construite et rendue + renders/s01.mp4, vérifiée sur images (planche) ET sur le son.
4. Une courte liste « pièges rencontrés » (pour que les Haiku ne les refassent pas).
Pourquoi ce prompt est construit ainsi.
- Il dit le sujet et la règle absolue (pas de violence) avant le style : l'IA ne peut pas deviner une limite.
- Il demande un contrat, pas seulement une scène : l'objectif est un modèle réplicable.
- Il impose de vérifier sur images ET sur le son : on prévient l'effet « c'est fini » sans preuve.
- La scène 1 est petite et poétique : on valide la DA sur douze secondes, pas sur tout le film.
Étape 2 : itérer sur la scène 1, le réalisateur regarde et corrige
Je regarde la scène, je dis ce qui ne va pas en une phrase, l'IA corrige et met la règle dans le contrat. Quatre versions ont été conservées.
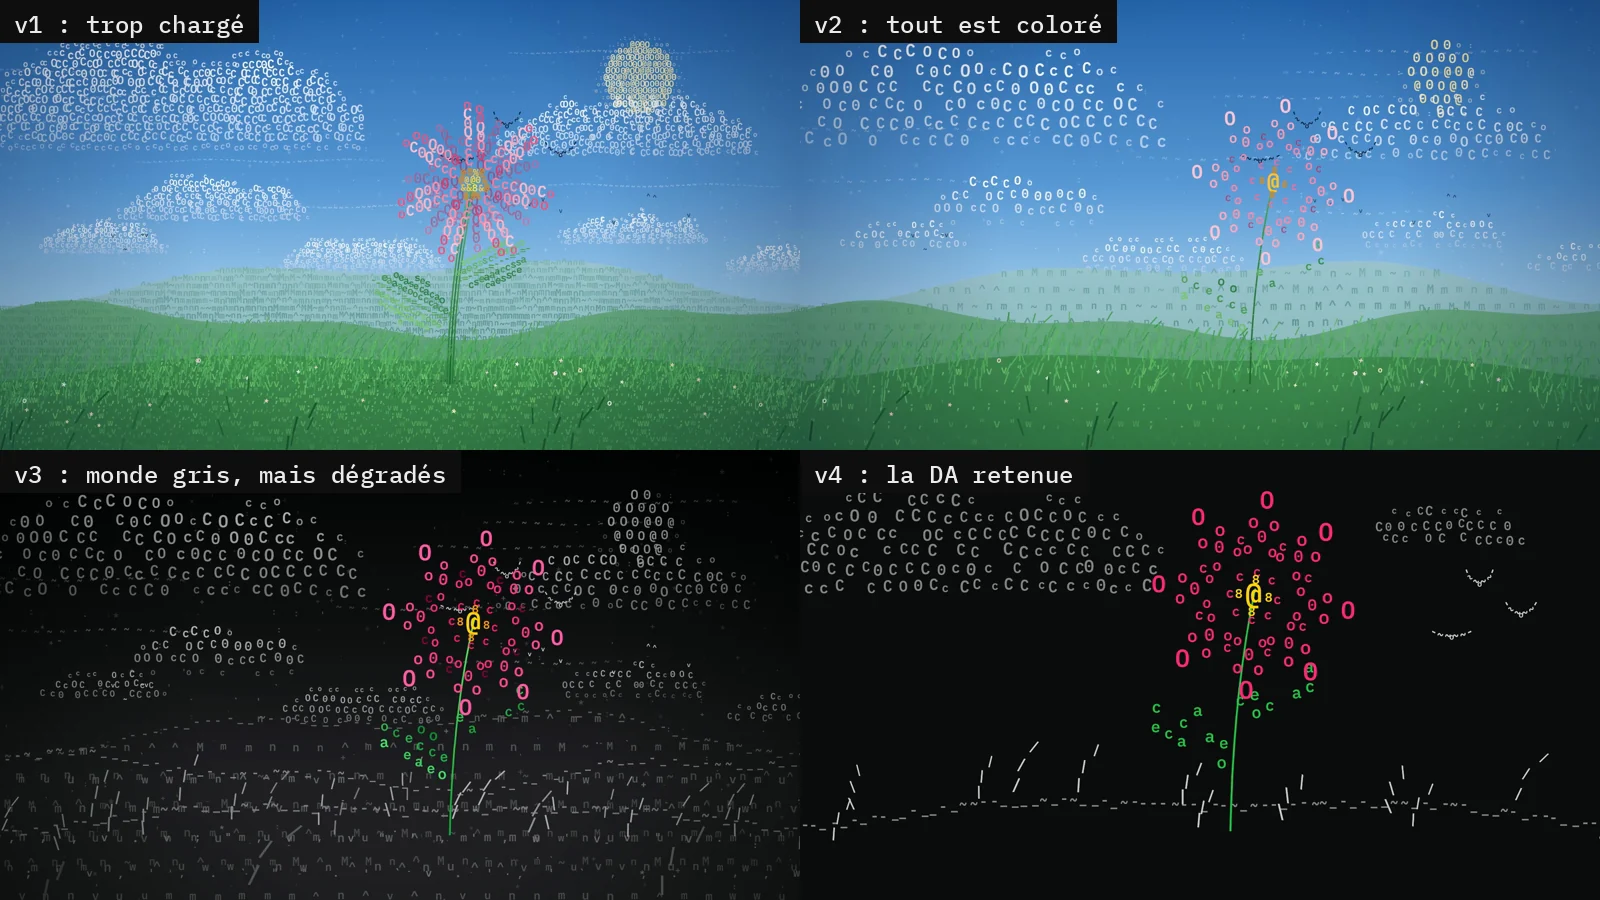 La scène 1 en quatre versions (
s01-v1-dense.mp4, s01-v2-couleur.mp4, s01-v3-gris-degrade.mp4, s01.mp4), même instant de la scène.
Mes trois retours, mot pour mot :
v1 → « Le son est bien, mais les nuages et la fleur sont trop chargés, il faut dessiner avec
      moins de lettres pour que ce soit plus poétique. »
v2 → « Il faut que la fleur ressorte plus, donc tout en noir et blanc, quelques herbes,
      et seule la fleur colorée. »
v3 → « Un peu moins d'éléments pour qu'on se concentre vraiment sur la fleur, moins de nuages,
      et pas de dégradé de couleur : couleur unie. »
Résultat mesuré : le nuage passe de 562 à 123 glyphes, la fleur d'environ 154 à 64 lettres de pétales, le fond devient un aplat #0E0E0E. Puis : « on tient notre DA ». Ces trois phrases sont devenues des règles dans DA.md (aplats, peu d'éléments, un seul élément coloré, lisible sur une planche réduite à 640 px).
À retenir : on ne décrit pas tout au départ ; la correction compte deux fois (l'image et le contrat).
Étape 3 : le scénario, la voix triste, les effets sonores
On passe au scénario : tu traduis tout en anglais, avec une voix triste et émotionnelle,
ElevenLabs V4. [le texte]
Je veux des SFX à ton avis, des scènes émotionnelles ; on met l'accent sur la nature ;
tu montres des chars, des enfants qui jouent ; la fleur est récurrente car au final tu montres
une flaque de sang et la fleur au vent ; des mouvements de caméra simples et des animations
simples ; tu lances la génération des scènes avec Haiku 5.5.
(Les « chars » seront supprimés plus loin : voir la section sur le changement d'avis.)
Ce qui est sorti : script.json (le texte et ses balises d'émotion), tools/tts_vo.py (génération avec timestamps), un casting de deux voix sur le même texte (Hale et Ash), une relecture whisper, et SCENARIO.md (9 scènes, durées, ce que dit la voix, la couleur unique de chaque scène, les sons).
{
 "model": "eleven_v4",
 "voice": { "stability": 0.3, "similarity": 0.8 },
 "text": "[sad, quiet, slow] When did we stop being human? [pause] When did other people's
   suffering stop moving us? [pause] When did we start hiding behind God... to commit
   atrocities? [pause] [voice trembling] So many people in this world are suffering, […]
   [softly] We... no longer feel anything. [pause] […]"
}
Pour les effets sonores, voici le type de texte qui a fonctionné avec sound-effect-v2 (toujours écrire no voices, no music) :
gentle steady breeze blowing over an open meadow, soft airy wind, no voices, no music, no birds,
no thunder, seamless texture
a few distant small birds chirping very faintly far away over a quiet countryside, sparse,
peaceful, no voices, no music
Piège réel, à connaître : eleven_v4 n'est pas un modèle d'effets sonores. Douze essais de vent n'ont donné que des souffles humains. Et un constat plus général : l'IA ne peut pas écouter. Elle a mesuré les niveaux ; c'est moi qui ai écouté.
Étape 4 : Haiku 5.5 réalise les scènes, en parallèle, par vagues
Chaque Haiku reçoit : sa ligne de SCENARIO.md, le contrat DA.md, le code de scenes/s01 (le modèle), le dossier des sons et la liste des contrôles. Voici le prompt-modèle, réellement utilisé (les crochets changent d'une scène à l'autre) :
Tu réalises UNE scène ([s02]) d'un court-métrage en animation « lettres et chiffres » pour Ahmed.
Dossier du film : [chemin]/lettres-guerre/.
Lis dans cet ordre, en entier : SCENARIO.md (ta scène = la ligne [s02] du tableau + les règles de
contenu), DA.md (le contrat : suis la checklist du §9, la QA du §10, les pièges du §11 et
l'avenant §12), puis scenes/s01/index.html (le modèle de code à copier : moteur de glyphes,
caméra, courbe de rafale).
Ta scène : [s02], [9 s] ([270] images à 30 i/s, 1920×1080), dans scenes/[s02]/ (copie de
scenes/s01/ puis adaptation), rendu final dans renders/[s02].mp4 avec le son de la scène mixé
(SFX listés dans SCENARIO.md, déjà générés ; pas de voix, pas de musique ; adapte
tools/mix_wind.py pour mixer).
Règles non négociables : fond uni, aplats sans aucun dégradé, 1 sujet + 2-3 décors, un seul
élément coloré (celui du tableau), caméra simple et jamais immobile plus d'1 s, animations
simples, aucune violence ni visage.
Procédure : écris le code, lance lint puis snapshots (hyperframes@0.6.112) et REGARDE les images
avant de rendre ; rends en arrière-plan avec la sortie redirigée vers un fichier ; attends la fin
du rendu ; ré-encode crf 19 ; fais la QA du §10 sur le MP4 final (ffprobe : [270] images, planche
regardée, crop zoomé lisible, fond uni, son crête ≤ −4 dBFS, caméra ≥ 8 px/s).
Ne touche PAS aux fichiers des autres scènes ni à SCENARIO.md/DA.md (si tu apprends un piège,
note-le dans scenes/[s02]/PIEGES.md). Ne publie rien.
Ne rends la main qu'une fois renders/[s02].mp4 rendu ET vérifié ; rapport final court en
français : chemin, ce qui est vérifié, ce qui ne l'est pas, écarts avec le scénario.
Après la première vague, j'ai ajouté (retour du réalisateur) : « le sujet doit se reconnaître sur la planche réduite à 640 px, ≥ 450 px de large, rien coupé par le bord, frame 0 déjà remplie, composition centrée sur le sujet. »
Pourquoi ce prompt est construit ainsi :
- Une scène par agent. Chacun a un périmètre clair, ne touche pas aux autres fichiers, et on peut les lancer en parallèle.
- Le contrat avant le code. L'ordre de lecture est imposé : scénario, contrat, modèle. L'agent ne part pas de zéro, il adapte.
- Des règles non négociables, écrites en une phrase. Elles servent de garde-fous quand l'agent hésite.
- Une procédure de contrôle intégrée : lint, snapshots regardés, rendu en arrière-plan, QA sur le MP4 final.
- « Ne rends la main que quand c'est vérifié » et un rapport honnête (ce qui est vérifié et ce qui ne l'est pas). Ce point a un historique : plusieurs agents avaient rendu la main alors que le rendu tournait encore.
Les vagues : vague 1 : s02 (enfants), s03 (ciel), s04 (aire de jeu vide), s05 (fenêtres) ; vague 2 : s06 (pluie), s09 (fleur et flaque) ; puis s07 et s08. Et j'ai demandé : « open chaque scène quand elle est finie » : l'IA ouvre chaque vidéo dès qu'elle est prête et donne son propre contrôle (planche lue, mesures).
Étape 5 : le réalisateur dit ce qui ne va pas, l'IA refait
Voilà le cœur du travail de réalisateur. Mes retours, tels quels :
s04 → « Corrige les chaussures et la balançoire, et surtout les chars on ne les voit pas. »
s03 → « Pour les chars ça passe pas, on va remplacer par des bombes qui tombent du ciel, et quand
       elle tombe elle fait un arc-en-ciel mais aussi un cratère ; surtout quand elle tombe,
       tu coupes tous les sons, rien, juste le silence. »
s09 → « Corrige la flaque, elle est trop discrète, et pourquoi pas pleuvoir du rouge aussi. »
     → « La pluie doit être partout dans la scène, pas uniquement près de la fleur. »
s03 → « Retire le nuage qui cache les missiles, on doit voir les missiles tomber et entrer le silence. »
s07 → « La bombe doit laisser un cratère, descendre plus vite, avoir plusieurs bombes, tu peux
       carrément changer toute la scène. »
     → « Tout est bon, mis à part les missiles qui ne tombent pas assez vite. »
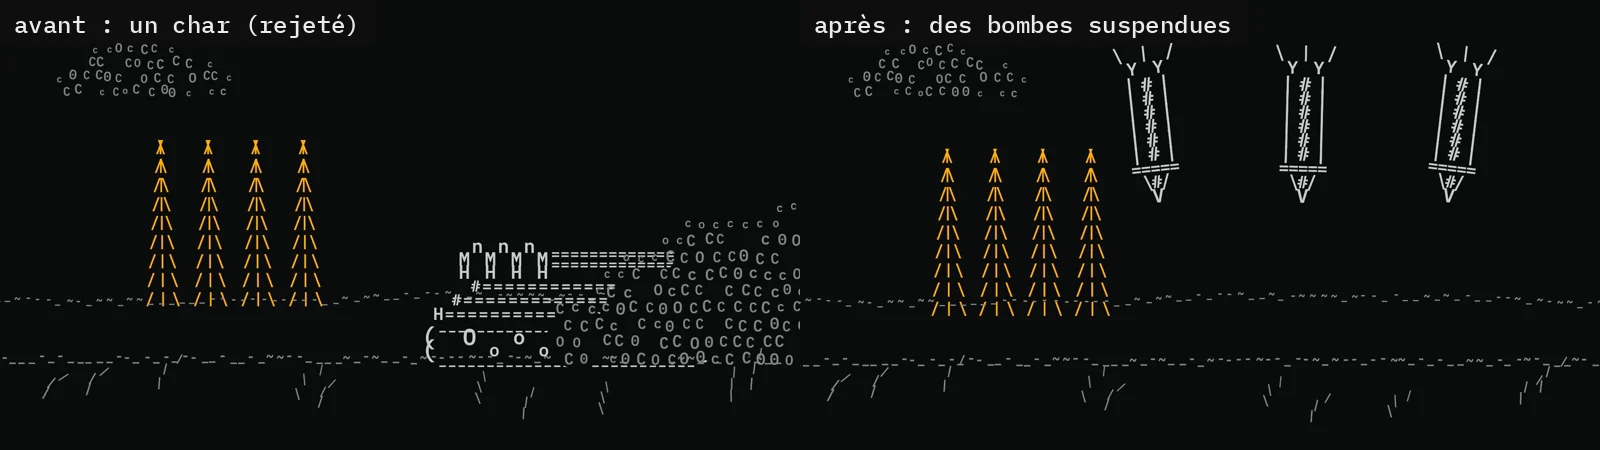 À gauche, la version 3 de la scène 3 (le char, rejeté). À droite, la version finale : des bombes, aucun char.
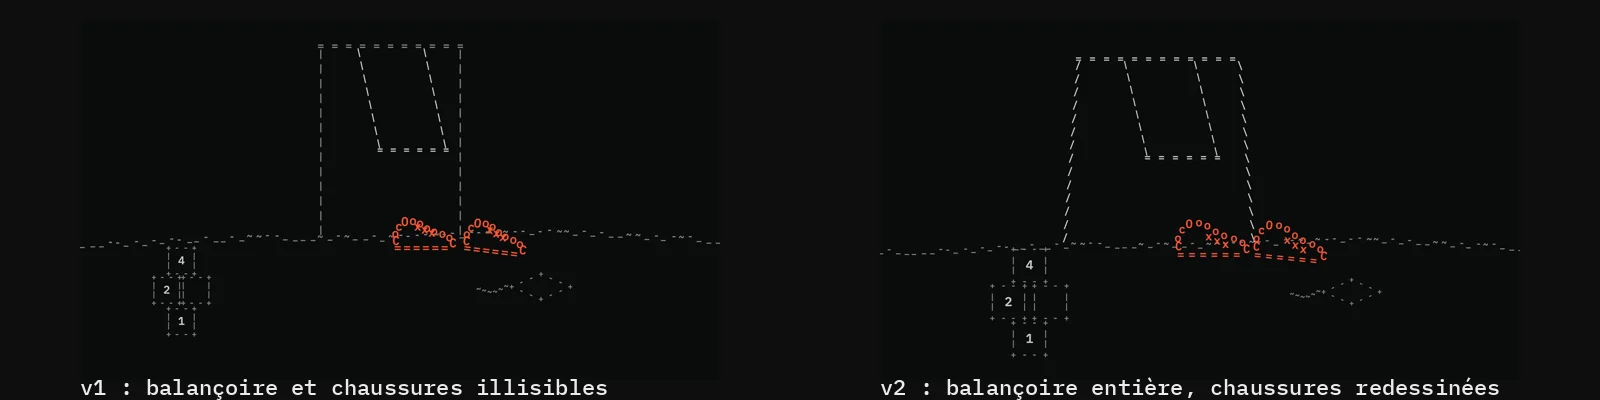 Le test des 640 px : si on ne reconnaît pas l'objet sur une planche réduite, il est trop petit ou trop flou. À droite, la scène 4 corrigée (balançoire entière, chaussures redessinées).
Un retour précis donne un résultat précis : la balançoire est entière, les chaussures sont redessinées (lacets en x, semelle en =), la flaque est remplie (plus de 700 px de large, rouge vif), la pluie rouge recouvre tout le cadre.
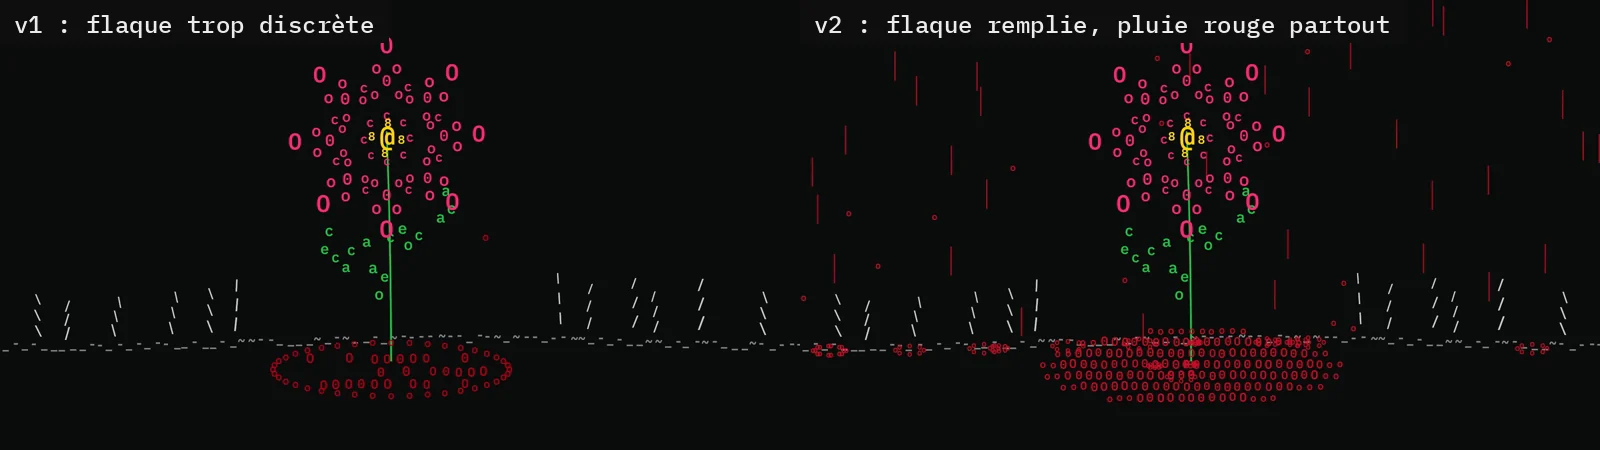 La flaque : à gauche trop discrète, à droite remplie et accompagnée de la pluie rouge partout. Une seule flaque dans tout le film, à la fin.
Étape 6 : le premier montage est rejeté
Les neuf scènes ont été assemblées avec la voix : 90,5 s (film-en.mp4). Je l'ai rejeté. Mon retour :
« On sent que chaque scène a été faite séparément, et même le son on sent qu'il a été généré séparément. Il faut de la fluidité. Baisse un peu le niveau des SFX. Pas de fondu enchaîné. L'idée de scène par scène ne marche pas : il me faut une sorte de travelling continu de la caméra, toutes les scènes liées comme si c'était un seul et même plan. Une seule grosse scène sans cut, la caméra bouge, parfois un léger zoom, parfois pas. Refais le son si besoin. On repart de zéro. »
Un seul Sonnet « réalisateur » a repris le film. Les neuf scènes sont devenues une bibliothèque de dessins, pas des plans. Voici le prompt (résumé fidèle de celui qui a été donné). C'est celui de la première version : sa règle « silence absolu » sera remplacée à l'étape 8, après que j'ai écouté le résultat.
Contexte donné : Ahmed a REJETÉ le film de 9 scènes assemblées (« chaque scène a été faite
séparément, même le son ; il faut de la fluidité ; baisse un peu les SFX ; pas de fondu
enchaîné ; un seul plan continu, une caméra qui voyage, parfois un léger zoom, parfois pas ;
refais le son si besoin ; on repart de zéro »).
Mission : UNE composition, UN monde continu en lettres sur fond uni, UNE caméra qui voyage
(spline lisse : position, vitesse, zoom ; jamais immobile > 1 s), UNE bande son continue.
Ordre du voyage (en suivant la voix) : fleur → enfants + cerf-volant → ciel, rayons ambre,
bombes → aire de jeu vide + chaussures → fenêtres qui s'éteignent → pluie bleue + point
d'exclamation → bombes qui tombent, cratères, arcs-en-ciel, SILENCE ABSOLU au premier impact
(≥ 3 s) → la nature reprend → retour à la MÊME fleur avec flaque rouge et pluie rouge partout
→ question finale, fondu de sortie ≤ 2 s.
Son : vent synthétisé piloté par la même courbe de rafale que les lettres ; sources sonores
posées dans le monde (niveau et panoramique selon la position de la caméra) ; SFX ≥ 12 dB sous
la voix ; aucune musique (v1) ; voix traitée (≈ −19 LUFS voix seule) ; film final ≈ −16 LUFS,
true peak ≤ −1,5 dBFS mesuré sur le fichier final.
Procédure : PLAN.md d'abord ; construire ; snapshots regardés ; rendre en tranches (frames
temporaires sur le disque externe) ; concaténer sans perdre une image ; QA sur le MP4 final
(continuité image par image, planche de 24 images, loudness, silence < −90 dBFS, whisper sur
la voix). Rapport honnête : ce qui n'a pas pu être écouté.
Retours suivants (v2) : physique des bombes (trajectoire balistique, plus de lévitation),
explosions rapides en lettres, boum puis coupure sèche du son, musique de voix a cappella
triste et épique.
Pourquoi ce prompt marche. Il garde la même discipline que celui de Haiku (plan écrit d'abord, snapshots regardés, QA sur le fichier final, rapport honnête) mais change d'échelle : un seul agent, un seul monde. Il formule le problème du réalisateur en contraintes vérifiables : aucun pic de différence entre images consécutives (donc pas de cut), caméra continue, son piloté par la même courbe que l'image.
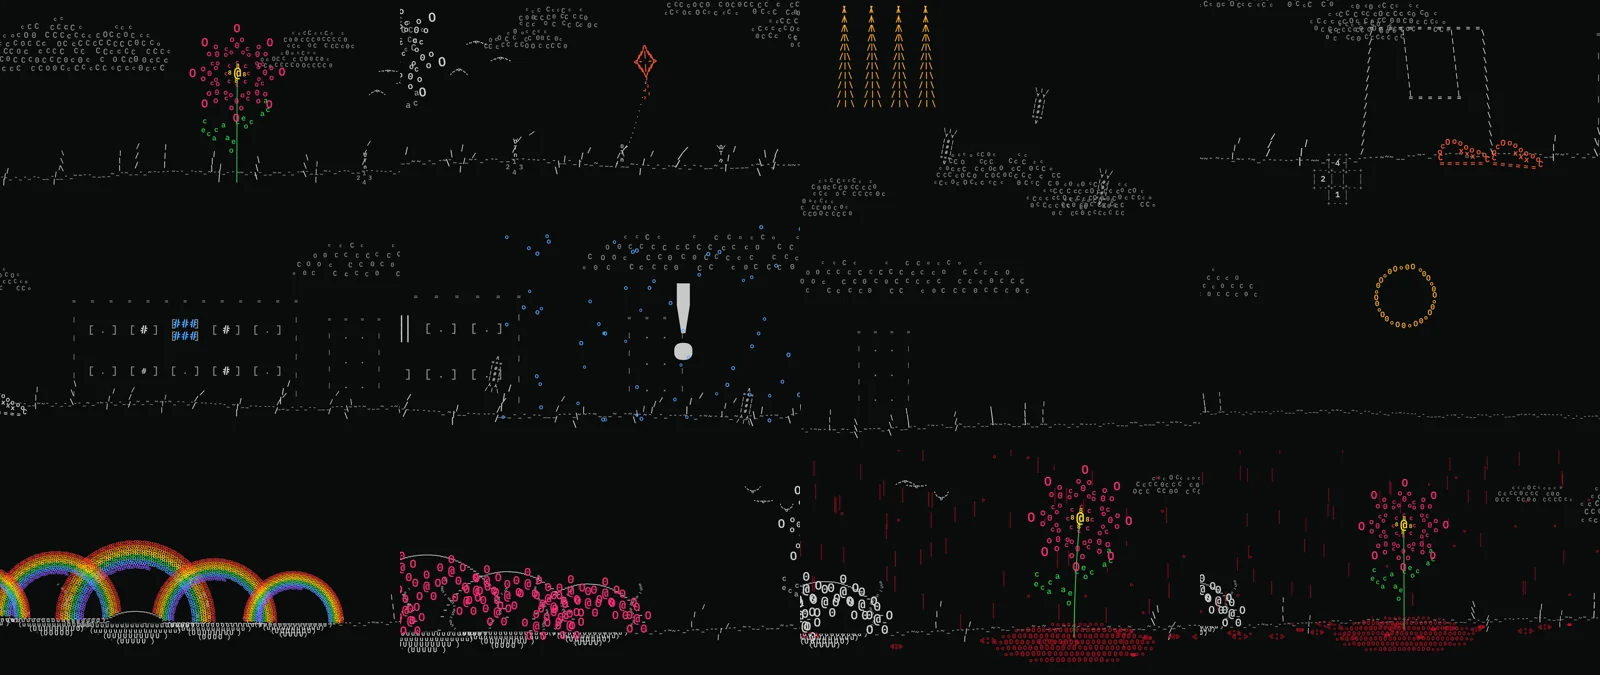 Douze images du film final (plan-séquence de 105 s, 3 150 images), prises avant et après la séquence d'explosion. Le voyage de la caméra : fleur, enfants, ciel, aire de jeu vide, fenêtres, pluie, cratères et arcs-en-ciel, nature qui reprend, retour à la même fleur.
Contrôles faits sur le fichier final : continuité (aucun pic de différence entre images consécutives), dérivée de la caméra continue, silence sous −90 dBFS (pour cette première version), loudness −16 LUFS, relecture whisper de la voix.
Étape 7 : encore des retours, la physique, l'explosion, la musique
Mon retour sur ce premier plan-séquence :
« La physique des missiles est vraiment mal faite, et la scène des explosions est super lente ; juste avant qu'il n'y ait plus de son, tu fais une explosion ; tout le reste est bien ; il faut une musique avec uniquement des voix, vocal, triste et épique. »
La deuxième version (conservée sous le nom plan-sequence-v2-silence.mp4) corrige trois choses :
- Les bombes suivent une vraie trajectoire balistique : le nez est aligné sur la vitesse, la trajectoire parabolique est mesurée, la vitesse à l'impact va de 2 298 à 2 678 px/s. Plus de « lévitation ».
- Les explosions sont en lettres et très rapides : 52 images entre le premier impact et la fin des cinq explosions. Une séquence brève, abstraite, sans corps ni visage.
- La musique est composée uniquement de voix, triste et épique : des segments générés avec ElevenLabs music et fal.ai (Stable Audio 2.5), assemblés et réglés pour rester sous la voix.
À ce stade le son coupait net après le boum, puis restait dans un silence numérique de 4,3 secondes. La mesure le confirme (voir la section sur le contrôle). Techniquement, c'était parfait.
Étape 8 : l'oreille du réalisateur
J'ai écouté. Mon retour :
« L'animation est presque parfaite, juste le son qui coupe d'un coup, pas top. Tu peux ajouter un bruit assourdissant et la musique continue. »
La coupure sèche, mesurée à la perfection, ne marchait pas à l'oreille : l'IA avait fait ce que le contrat disait (« silence absolu »), mais c'était mon jugement, pas une mesure, qui disait que ça ne marchait pas. La version finale remplace donc le silence :
- le boum garde son choc (pic à 66,0 s, au moment de l'impact visuel) ;
- puis un acouphène, un sifflement aigu continu vers 3,4 kHz, monte en 0,1 s et décroît lentement jusqu'à environ 70,5 s ;
- le monde est étouffé : vent, effets sonores et musique passent par un filtre passe-bas qui se rouvre progressivement ;
- la musique de voix continue sans trou.
L'image n'a pas bougé : seule la bande son a été refaite (les 3 150 images sont identiques à la version précédente). Mesures sur le MP4 final : 105 s, 3 150 images, −15,8 LUFS, crête à −1,7 dBFS. L'IA a mesuré, elle n'a pas jugé : c'est la différence entre vérifier et diriger.
Le film terminé : https://youtu.be/pyDx5ITCebE?t=274 (le film complet commence à 4:34 dans le tutoriel).
Comment contrôler la qualité de l'IA
C'est la section la plus importante de ce guide. Un agent qui rend un fichier sans erreur ne t'a pas prouvé que ce fichier est bon. Voici comment j'ai contrôlé, en six principes.
1. Faire voir
- La planche réduite à 640 px de large. Si on ne reconnaît pas l'objet sur la planche, il est trop petit ou trop flou. Commande utilisée :
ffmpeg -i renders/s02.mp4 -vf "select='not(mod(n\,45))',scale=640:-1,tile=4x2" -frames:v 1 planche.jpg
- Un crop zoomé ×2 : on doit y lire des lettres (c'est la DA).
- Douze images consécutives pour juger une chute : c'est comme ça qu'on voit une « lévitation » ou une accélération qui n'existe pas.
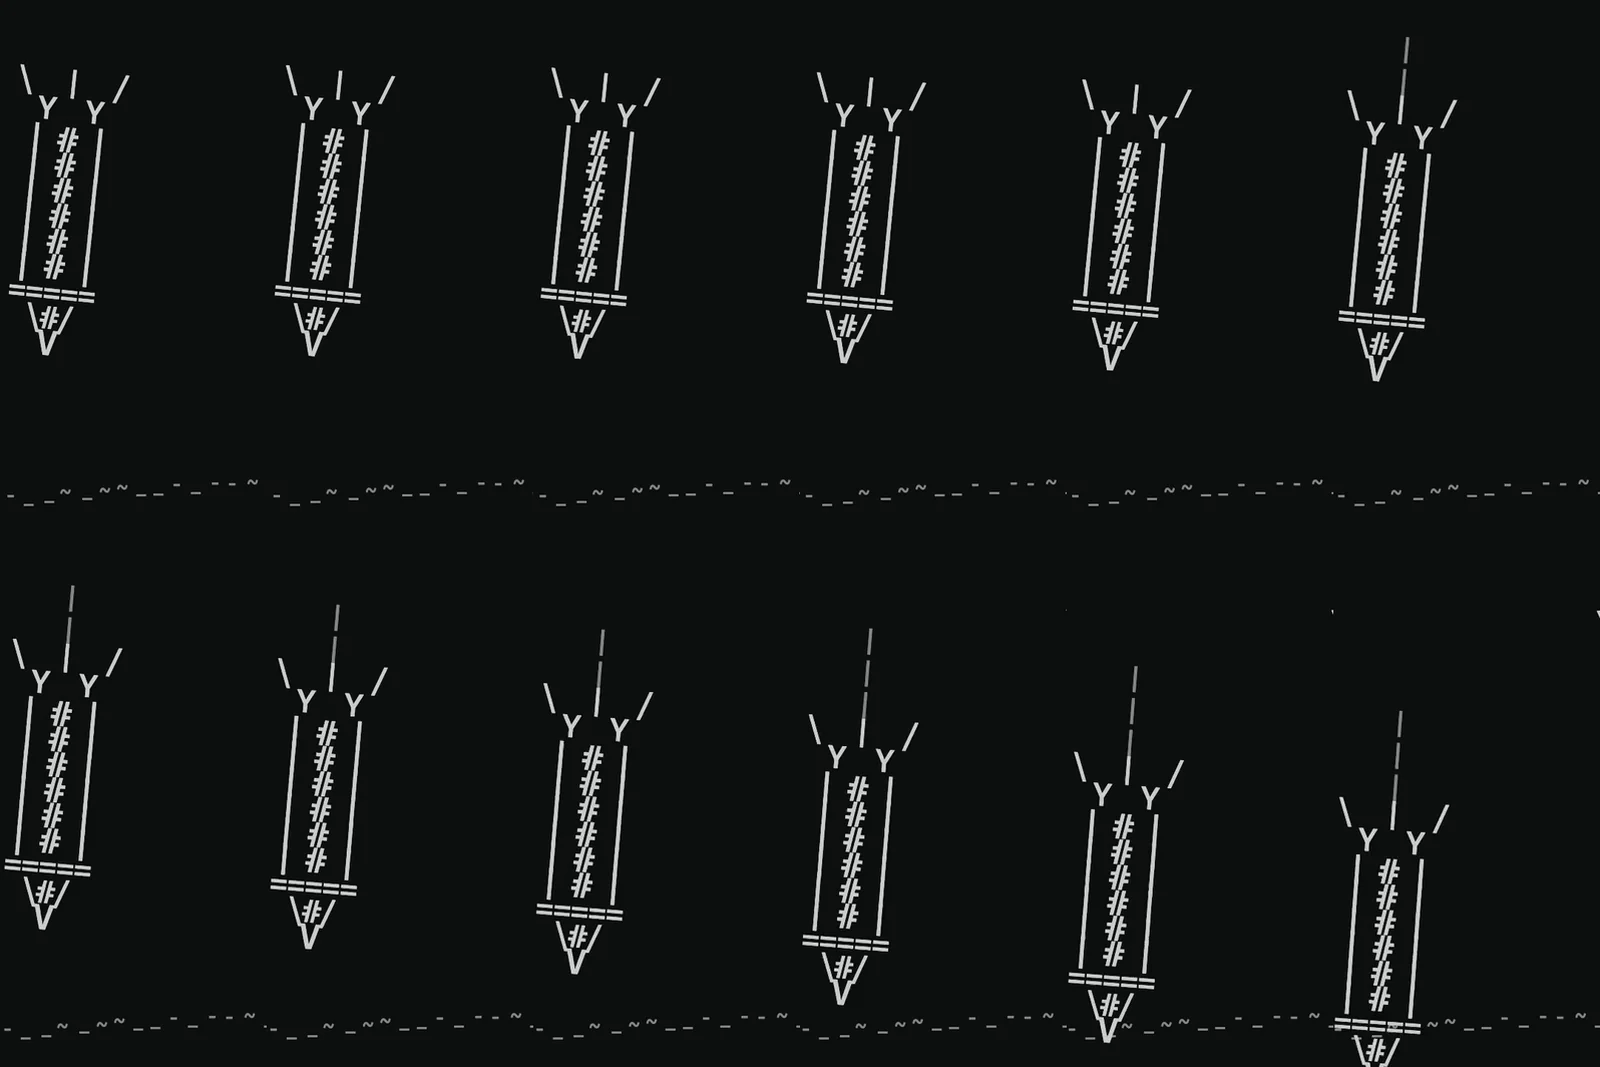 Douze images consécutives d'une chute (scène 3, avant l'impact) : le déplacement entre deux images augmente, la traîne apparaît quand la vitesse monte.
2. Faire mesurer
- Le niveau : intégré en LUFS, crête (true peak). Cibles ici : film final autour de −16 LUFS, crête de −1,5 dBFS ou moins (mesuré : −15,8 LUFS, −1,7 dBFS).
- Le silence (quand le contrat le demande) :
volumedetect, et on veut moins de −90 dBFS après l'impact. Pour le film final, ce silence a été remplacé par un acouphène : la mesure sert alors à vérifier que la musique ne s'interrompt pas. - Le nombre d'images : durée × 30 (12 s = 360 images).
- La vitesse de chute et de caméra, en pixels par seconde.
# nombre d'images
ffprobe -v error -select_streams v -count_frames -show_entries stream=nb_read_frames -of csv=p=0 renders/s02.mp4
# crête et loudness : toujours filtrer la sortie (une ligne toutes les 0,1 s)
ffmpeg -i renders/s02.mp4 -vn -af volumedetect,ebur128=peak=true -f null - 2>&1 | grep -E "max_volume|I:|Peak"
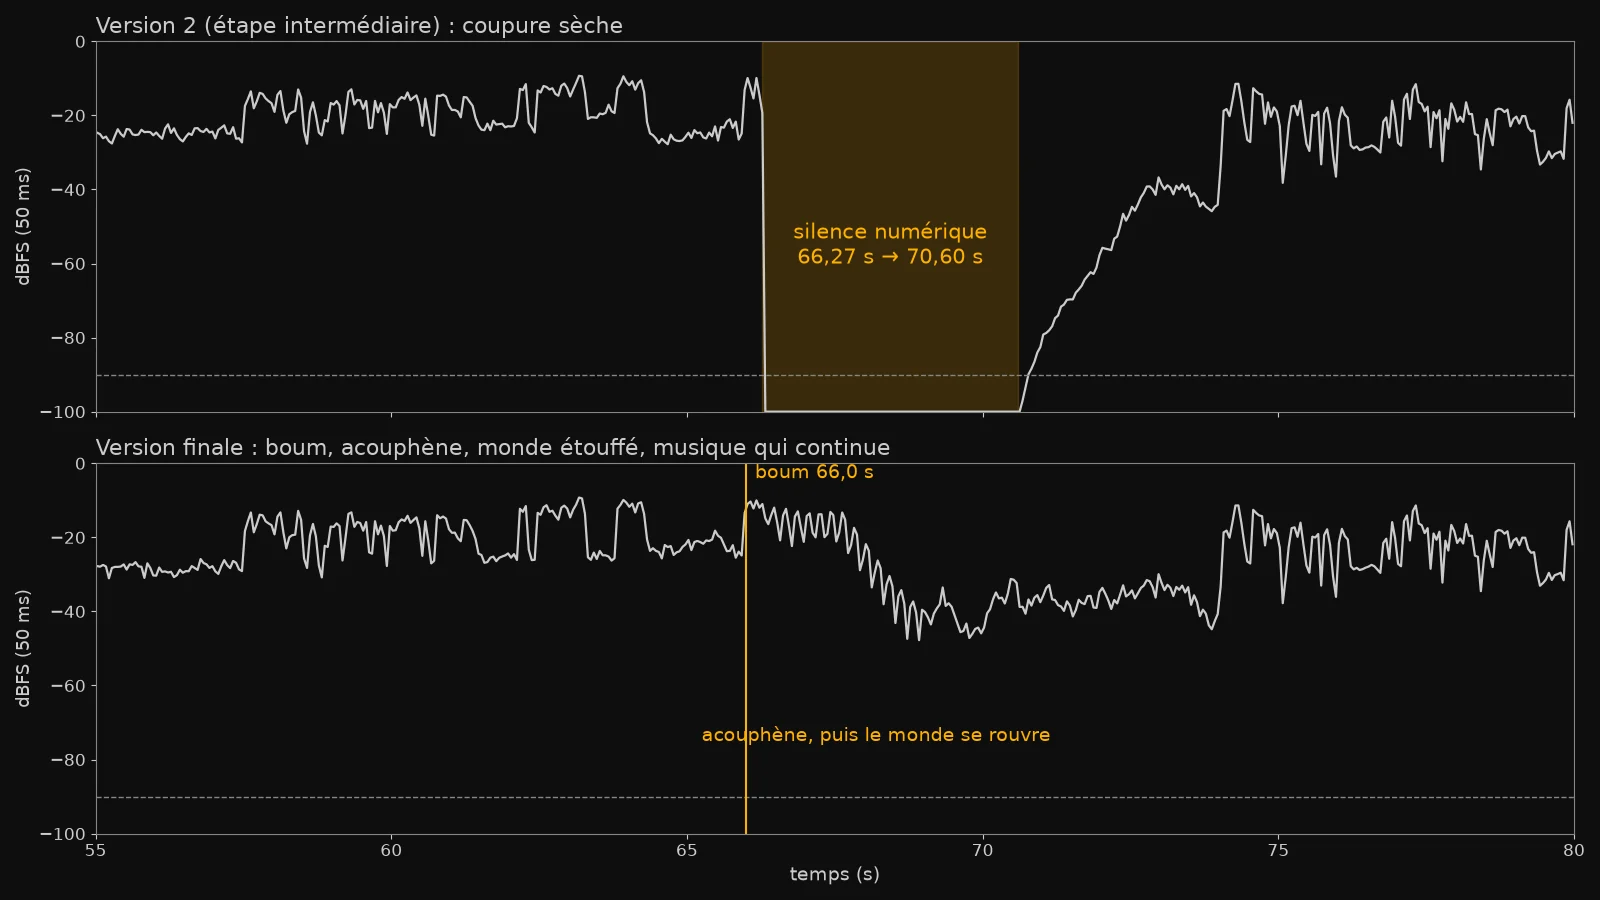 En haut, la version 2 (étape intermédiaire, conservée) : zéro échantillon non nul de 66,27 s à 70,60 s. Un AAC ne rend jamais un zéro exact : il a fallu terminer la coupure avant l'impact visible. En bas, la version finale : après le boum le niveau baisse (monde étouffé, acouphène) mais la musique continue, sans trou (niveau minimal −47,8 dBFS entre 66 et 71 s).
3. Faire relire
Retranscris la voix avec whisper, par morceaux de 10 secondes, et compare au texte écrit :
whisper-cli -m ggml-small.bin -l en -nt -f voix-morceau.wav
C'est ainsi qu'on a trouvé « we no longer feel anything » avalé par le mode chuchoté.
4. Ne jamais croire « c'est fini »
Les pièges qui m'ont été réellement servis :
- Plusieurs agents ont rendu la main alors que le rendu tournait encore.
- Un lint vert ne prouve rien (l'exception qui supprimait la fleur).
- L'AAC remonte la crête : mesurer le fichier final, pas le WAV.
sed -isur macOS échoue en silence sans extension (sed -i '').-shortestcoupe une image au muxage.- Une commande passée dans
| tailcache le code retour de la vraie commande. - Les timestamps ElevenLabs dérivent de 0,1 à 0,7 s : on coupe aux vrais silences.
5. Garder ce que l'IA ne peut pas faire
Écouter (l'IA n'a jamais entendu le film) et juger (la beauté, l'émotion, la fluidité). C'est le réalisateur. C'est moi qui ai senti que le son avait été « généré séparément » : aucune mesure ne l'aurait signalé.
6. Demander des rapports honnêtes
Dans chaque prompt : « rapport final court : ce qui est vérifié, ce qui ne l'est pas, écarts avec le scénario ». Et pour le film final : « Rapport honnête : ce qui n'a pas pu être écouté. » Un rapport qui dit ce qu'il n'a pas vérifié vaut plus qu'un rapport parfait.
Comment changer d'avis et refaire une scène
La bonne nouvelle : changer d'avis ne coûte presque rien. À condition d'une règle de fer : on renomme l'ancienne version, on ne l'écrase jamais, on redemande, on compare.
Les versions, renommées, jamais écrasées
Dans renders/, tout est resté :
s01-v1-dense.mp4   s01-v2-couleur.mp4   s01-v3-gris-degrade.mp4   s01.mp4
s03-v1.mp4  s03-v2.mp4  s03-v3-char.mp4  s03-v4-nuage.mp4  s03-v5-lente.mp4  s03.mp4
s07-v1-char.mp4  s07-v2-lente.mp4  s07-v3-lente.mp4  s07.mp4
s09-v1.mp4  s09-v2.mp4  s09.mp4
film-en.mp4 (9 scènes collées, rejeté)   plan-sequence-v1.mp4 (plan unique, version 1)   plan-sequence-v2-silence.mp4 (v2, coupure sèche)
plan-sequence-en.mp4 (film final, v3)
La scène 3 a six versions. Le nom dit pourquoi on a changé : v3-char (le char), v4-nuage (le nuage qui cachait les bombes), v5-lente (les bombes qui tombaient trop lentement). Si la nouvelle version est moins bonne, l'ancienne est toujours là.
Les chars deviennent des bombes
La scène 3 contenait un char : l'IA l'avait d'abord dessiné comme un « wagon plat », puis avec de meilleures proportions (tourelle, canon, chenilles). Ça ne passait toujours pas. J'ai tranché : « pour les chars ça passe pas ». Les chars ont disparu de tout le film, remplacés par des bombes qui tombent du ciel ; chaque bombe laisse un cratère, d'où sort un arc-en-ciel, et au premier impact tous les sons sont coupés (un choix qui sera lui-même remplacé dans le film final : voir l'étape 8).
Le montage rejeté : repartir de zéro, mais pas de rien
Quand j'ai rejeté le montage scène par scène, j'ai demandé de repartir de zéro, pas de rafistoler les raccords. Les neuf scènes ont gardé leur valeur comme bibliothèque de dessins : le plan-séquence les réutilise, mais pas leurs caméras ni leurs fondus.
La physique, l'explosion, la musique, puis le son
Troisième tour (étape 7) : trajectoire balistique crédible, explosions en lettres très rapides, musique de voix seules. Quatrième tour (étape 8) : la coupure sèche remplacée par un acouphène, la musique qui continue. Chaque correction s'est faite sans toucher à ce qui était juste (« tout le reste est bien », « l'animation est presque parfaite »). Et la version « silence » est restée, nommée comme telle : si l'acouphène avait déplu, un retour en arrière était un simple renommage.
Des phrases de retour qui marchent
Les retours qui ont fonctionné ont tous les mêmes qualités : courts, concrets, observables. Voici les modèles que j'en tire (construits à partir de mes retours ci-dessus) :
| Ce que tu veux | Modèle de phrase | Exemple réel |
|---|---|---|
| Alléger | « C'est trop chargé : [objet] avec moins de [éléments]. » | « les nuages et la fleur sont trop chargés, il faut dessiner avec moins de lettres » |
| Mettre en valeur | « [Sujet] doit ressortir : le reste en [gris], seul [sujet] en couleur. » | « tout en noir et blanc, seule la fleur colorée » |
| Rendre lisible | « [Objet] n'est pas lisible : corrige-le. » | « les chars on ne les voit pas » |
| Remplacer | « [X] ne passe pas : remplace par [Y], qui [effet voulu]. » | « les chars, ça passe pas, on va remplacer par des bombes » |
| Accélérer | « [Objet] ne [mouvement] pas assez [vite/fort]. » | « les missiles ne tombent pas assez vite » |
| Agrandir | « [Élément] est trop discret : [ce que tu veux voir]. » | « la flaque est trop discrète » |
| Étendre | « [Effet] doit être partout, pas seulement près de [sujet]. » | « la pluie doit être partout dans la scène » |
| Réparer un détail qui sonne faux | « [Ce qui est bien] est presque parfait, juste [détail] ne marche pas à l'oreille : [ce que tu veux à la place], et [ce qui continue]. » | « l'animation est presque parfaite, juste le son qui coupe d'un coup, pas top, ajoute un bruit assourdissant et la musique continue » |
| Valider le reste | « Tout est bon, mis à part [point précis]. » | « tout est bon, mis à part les missiles » |
| Repartir | « Ça ne marche pas : [raison]. On repart de zéro. » | « chaque scène a été faite séparément… on repart de zéro » |
Deux règles de pratique : dis ce qui est faux, pas seulement que c'est faux, et dis ce qui est juste pour qu'il n'y touche pas.
Ce dont tu as vraiment besoin
Pas de matériel de studio, mais quelques briques. Aucun prix n'est donné ici : vérifie le tarif actuel de chaque service.
- Un ordinateur capable de rendre une vidéo en local, et de la place disque : le rendu écrit beaucoup d'images temporaires (ici, sur un disque externe).
- Claude Code, avec un accès aux modèles Sonnet 5.5 et Haiku 5.5 (vérifie le tarif actuel).
- Un compte ElevenLabs pour la voix, les effets sonores et la musique ; attention aux quotas (un script de secours existe pour la musique). Vérifie le tarif actuel.
- Node.js pour
npx hyperframes, ffmpeg et whisper.cpp (whisper-cli) installés en local, Python 3 pour les scripts de mixage et de contrôle. - Un bon casque ou de bonnes enceintes : l'IA n'écoute pas, toi si.
- Un message : sans lui, l'outil tourne dans le vide.
Les erreurs à éviter
- Tout décrire d'avance. Décris la première scène, regarde, corrige.
- Écraser une version. Renomme-la, tu pourrais la regretter.
- Croire « c'est fini » ou se fier au lint. Exige un rapport de ce qui est vérifié et de ce qui ne l'est pas.
- Demander des effets sonores à un modèle de voix. Utilise un modèle d'effets.
- Lancer trop d'agents d'un coup. Vagues de quatre.
- Assembler des scènes séparées et croire à un plan continu. On sent la couture, à l'image comme au son.
- Trop de détail. Moins de lettres, plus de poésie.
- Montrer la violence. Suggère. Ici, aucun corps, aucun visage, aucune arme visible.
- Déléguer l'oreille. L'IA mesure, elle n'écoute pas : une coupure sèche parfaitement mesurée peut sonner faux.
- Promettre « en un seul prompt ». Ce n'est pas vrai, et ça abîme la confiance.
Pour aller plus loin
- Le pipeline technique de montage local : monter une vidéo avec l'IA en local avec Claude Code et HyperFrames.
- Le panorama des outils : le montage vidéo avec l'IA et les générateurs de vidéo IA.
- La narration : la voix off IA, le guide.
- Le film : https://youtu.be/pyDx5ITCebE?t=274 ; le tutoriel vidéo : https://youtu.be/pyDx5ITCebE (français) et https://youtu.be/XigOMjfS7GE (anglais).
Ton film n'a pas besoin d'animations ultra détaillées. Il a besoin de ta vision. Le reste, tu le diriges.
Questions fréquentes
- Peut-on réaliser un court-métrage d'animation avec l'IA en un seul prompt ?
- Non, et ce guide ne le promet pas. Pour ce film, il a fallu des dizaines d'échanges avec Claude Code : une description de la vision, une direction artistique validée sur une première scène, un scénario, des scènes réalisées par plusieurs agents, puis des retours du réalisateur (plus de lettres, moins de couleur, des bombes à la place des chars) et un montage entièrement refait. L'IA exécute vite ; la vision, le goût et les corrections restent à toi.
- Faut-il savoir dessiner ou coder pour faire un court-métrage avec l'IA ?
- Tu n'as pas à dessiner : ici tout est dessiné avec des lettres et des chiffres par du code que Claude Code écrit. En revanche, il faut accepter de travailler dans un terminal, de lancer une commande, d'ouvrir un fichier vidéo et de dire en une phrase ce qui ne va pas. Le métier qui compte est celui de réalisateur : savoir ce que tu veux dire, regarder, écouter, trancher.
- Pourquoi utiliser Sonnet 5.5 pour la direction artistique et Haiku 5.5 pour les scènes ?
- Sonnet 5.5 (effort « high », pas plus) sert à décrire le film, valider le style et fabriquer les premières scènes « types » ainsi que le contrat de direction artistique (DA.md). Haiku 5.5, plus rapide, réalise ensuite les autres scènes en parallèle, par vagues de quatre, en suivant ce contrat et le code de la scène modèle. Un modèle plus petit n'a rien à deviner si le modèle est précis.
- L'IA peut-elle vérifier que le son est bon ?
- Elle peut le mesurer (niveau en LUFS, crête, silence sous -90 dBFS) et relire la voix avec whisper.cpp pour comparer le texte dit au texte écrit. Elle ne peut pas l'écouter. L'écoute et le jugement (beauté, émotion, fluidité) restent à l'humain : j'ai rejeté un premier montage où le son se sentait « généré séparément », puis une coupure sèche du son, parfaitement mesurée (silence numérique de 4,3 s), qui « ne marchait pas » à l'oreille.
- Combien de temps et d'argent faut-il pour faire un court-métrage comme celui-ci ?
- Nous ne l'avons pas mesuré, donc nous ne donnons pas de chiffre. Ce qui est mesuré : le film final est un plan unique de 1 min 45 (105 s et 3 150 images), et plusieurs versions de chaque scène ont été conservées ; le son final mesure −15,8 LUFS, crête à −1,7 dBFS. Pour le coût, vérifie le tarif actuel de ton abonnement Claude Code et de ton compte ElevenLabs ; ils changent.
#animation ia #claude-code #court-métrage #direction artistique #elevenlabs #hyperframes